LLM 有两个先天限制:知识停在训练截止日期,你的私有文档、内部资料也不在它的训练语料里。直接问,轻则答"不知道",重则一本正经地编。RAG(Retrieval Augmented Generation)就是针对这两个问题的标准解法:先从你自己的文档集合里检索出与问题最相关的几段文本,连同问题一起交给模型,让它基于给定材料作答。
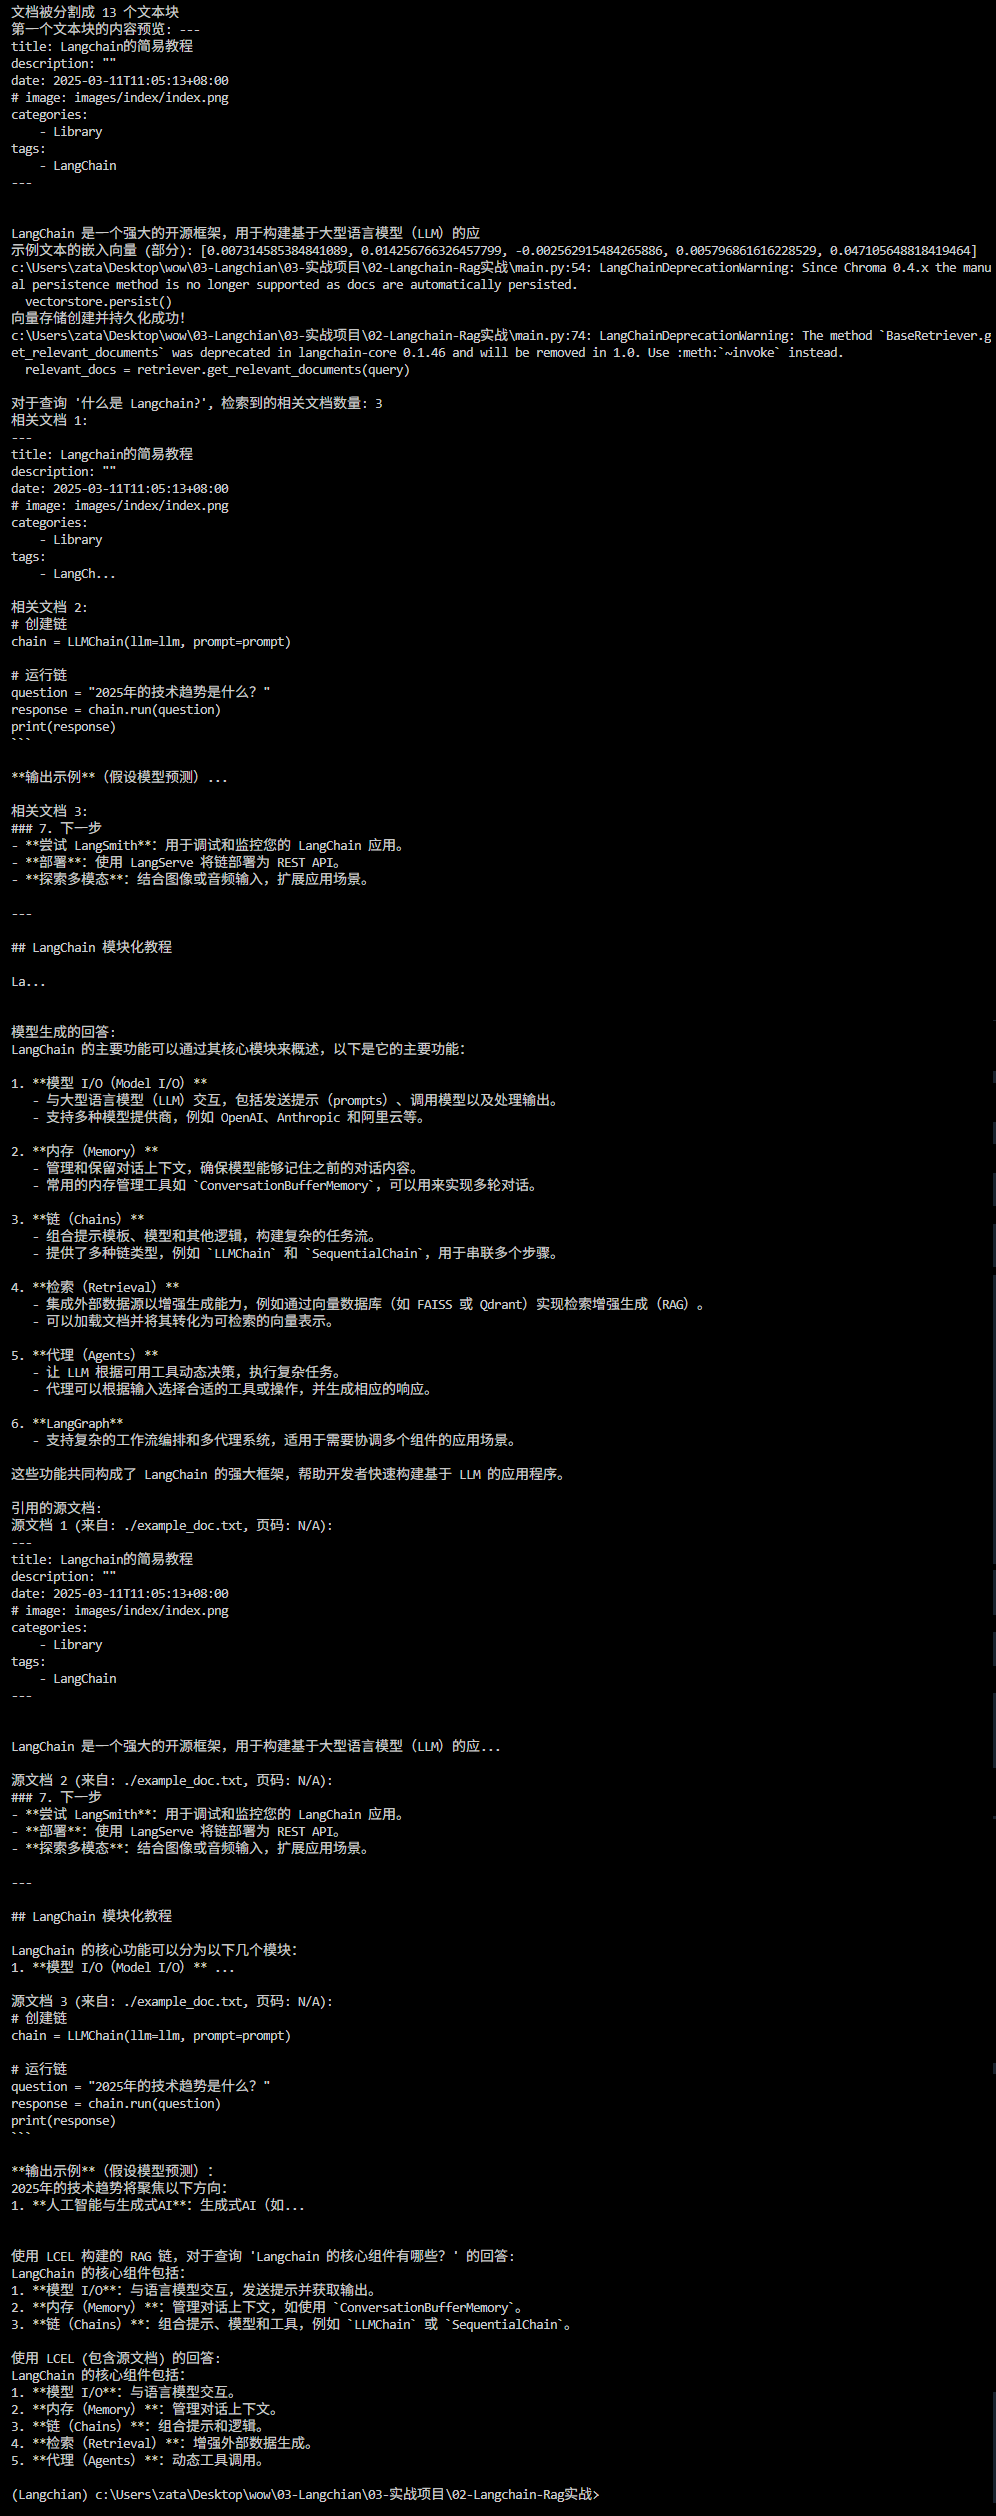
这篇文章以我实际跑通的一套为例:阿里云百炼提供的 Embedding 模型和 qwen 系模型,LangChain 做编排,Chroma 做向量库。完整代码在同目录 main.py,知识库是 example_doc.txt(一篇约一万字符的 LangChain 教程文本),运行截图见下文。正文以现在还能跑的写法为准;当年 0.1 时代的老 API(RetrievalQA、get_relevant_documents() 等)单独开一节做注记,不占主线。
动手之前先回答选型问题:什么时候用 RAG,什么时候微调。
| 维度 | RAG | 微调 |
|---|---|---|
| 知识更新 | 换文档立即生效 | 需重新训练 |
| 擅长 | 私有知识问答、事实性回答 | 固定的风格、格式、领域行为 |
| 成本 | 主要是检索和推理开销 | 算力 + 数据准备 + 训练周期 |
| 可解释性 | 回答可溯源到具体文档 | 难以溯源 |
我的判断:知识层面的问题优先 RAG,微调解决的是"怎么说话"而不是"知道什么"。两者不冲突,可以叠加,但大多数场景先把 RAG 做好就够用了。
RAG 的核心组件:一条数据流
一个 LangChain RAG 应用的组件可以串成一条数据流看:
原始文档
   │  Document Loaders(加载)
   ▼
Document(整篇 page_content + metadata)
   │  Text Splitters(分割)
   ▼
chunks(小块文本,继承 metadata)
   │  Embedding 模型(向量化)
   ▼
向量 → Vector Store(落库)
   │  用户提问同样转向量,相似度检索 top-k(Retriever)
   ▼
问题 + 相关 chunks(拼进 Prompt)
   │  LLM(生成)
   ▼
基于文档的回答
对应到具体组件:
| 组件 | 职责 | 本文用的实现 |
|---|---|---|
| Document Loaders | 从 txt/PDF/网页等来源读入文档 | TextLoader |
| Text Splitters | 把长文档切成语义连贯的小块 | RecursiveCharacterTextSplitter |
| Embedding 模型 | 文本转向量 | 百炼 text-embedding-v2 |
| Vector Store | 存向量,提供相似度检索 | Chroma |
| Retriever | 统一检索接口,取 top-k | as_retriever() |
| LLM | 基于上下文生成回答 | qwen-plus(OpenAI 兼容模式) |
| 链(编排) | 把上面串成完整流程 | LCEL |
前四类组件是"建索引"阶段,Retriever 和链是"查询"阶段。索引建一次可以服务无数次查询,知识更新只需重建索引——这是 RAG 相对微调灵活的根源。
实战:百炼 + LangChain + Chroma 端到端
阿里云百炼(Model Studio)是阿里云的大模型服务平台,qwen 系模型和 text-embedding 系向量模型都能通过 DashScope API 调用,并且提供 OpenAI 兼容接口——chat 侧可以直接用 langchain-openai 的 ChatOpenAI 接入,不需要专门的 SDK 封装。
源文件与运行结果
说明:同目录的
main.py是当时跑通的原始代码,里面还保留着 0.1 时代的写法(from langchain.text_splitter import ...、get_relevant_documents()、vectorstore.persist()、RetrievalQA)。本文正文按当前版本的写法整理过,对照源码阅读时注意区分。
| 源文件 | 说明 |
|---|---|
| example_doc.txt | 知识库文本,一篇约一万字符的 LangChain 教程 |
| main.py | 完整可运行代码 |
准备:依赖与 API Key
pip install langchain langchain-community langchain-openai langchain-text-splitters chromadb dashscope python-dotenv
dashscope 是 DashScopeEmbeddings 的依赖;如果嵌入走 OpenAI 兼容接口(见下文),这个包也可以不装。去百炼平台申请 API Key,写入脚本同目录的 .env:
DASHSCOPE_API_KEY="sk-xxxxxxxxxxxxxxxx"
import os
from dotenv import load_dotenv

load_dotenv()
模型名以百炼的模型列表为准:https://help.aliyun.com/zh/model-studio/getting-started/models
加载与分割
from langchain_community.document_loaders import TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter

loader = TextLoader("./example_doc.txt", encoding="utf-8")
documents = loader.load()

text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
texts = text_splitter.split_documents(documents)
print(f"文档被分割成 {len(texts)} 个文本块")
两个参数直接决定检索质量:chunk_size 是每块的最大字符数,太大则一块里混进多个主题、检索不精准,太小则上下文碎、嵌入的语义信息不够;chunk_overlap 是相邻块的重叠字符数,用来避免关键句恰好被切断。1000/200 是常见的起步值,值得针对自己的文档实测调整。
读 PDF 把 TextLoader 换成 PyPDFLoader 即可,分割逻辑完全复用。
版本差异:0.1 时代的教程写 from langchain.text_splitter import ...,现在分割器拆到了独立的 langchain_text_splitters 包,老路径已废弃。
嵌入
from langchain_community.embeddings import DashScopeEmbeddings

embeddings_model = DashScopeEmbeddings(model="text-embedding-v2")

# 快速自检:随便嵌一句话,能出向量就说明模型和 Key 都通了
example_embedding = embeddings_model.embed_query("这是一个示例文本,用于测试嵌入模型。")
print(f"向量维度: {len(example_embedding)}")
⚠️ DashScopeEmbeddings 来自 langchain_community(依赖 dashscope SDK),属于 legacy 集成,不保证长期维护。新代码可以直接走百炼的 OpenAI 兼容接口,与本站其他文章的做法一致:
from langchain_openai import OpenAIEmbeddings

embeddings_model = OpenAIEmbeddings(
    model="text-embedding-v2",
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    check_embedding_ctx_length=False,  # 关掉 OpenAI 特有的长度检查,否则会报错
)
向量库:Chroma
from langchain_community.vectorstores import Chroma

vectorstore = Chroma.from_documents(
    documents=texts,
    embedding=embeddings_model,
    persist_directory="./chroma_db",
)
指定 persist_directory 之后,数据在写入时自动落盘,下次运行用 Chroma(persist_directory="./chroma_db", embedding_function=embeddings_model) 直接加载,不必重建索引。
几个容易踩坑的点:
- 0.1 时代教程里常见的
vectorstore.persist()不要再写了。Chroma 早就自动持久化,这个方法在新版集成里已被移除,留着只会报错。 langchain_community.vectorstores里的 Chroma 是老路径,官方现在推荐独立包:pip install langchain-chroma,然后from langchain_chroma import Chroma,参数一致。- FAISS 也是常用选择:
FAISS.from_documents(texts, embeddings_model)一行建库,纯内存、速度极快,适合原型验证;需要持久化时自己调save_local()/load_local()。
检索器
retriever = vectorstore.as_retriever(search_kwargs={"k": 3})

relevant_docs = retriever.invoke("什么是 Langchain?")
print(f"检索到 {len(relevant_docs)} 个相关文档块")
for i, doc in enumerate(relevant_docs):
    print(f"文档 {i+1}: {doc.page_content[:150]}...")
k=3 即取相似度最高的 3 个块。Retriever 是 LangChain 的统一检索接口,向量库、多路召回、压缩检索都实现同一个接口,后面换策略不用改下游代码。
版本差异:老教程里的 retriever.get_relevant_documents(query) 已废弃,统一用 retriever.invoke(query)。
生成模型:qwen-plus
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    model="qwen-plus",  # 模型列表: https://help.aliyun.com/zh/model-studio/getting-started/models
)
这是百炼的 OpenAI 兼容模式:langchain-openai 一个包通吃 qwen 系模型(qwen-plus、qwen-max 等),换模型只改 model 字符串,我的 main.py 走的就是这条路。另一条路是 langchain_community 的 ChatTongyi(或更新包里的 langchain-alibaba),同样属于 legacy 集成,除非依赖 DashScope SDK 的特有能力,否则兼容模式这条最省事。
用 LCEL 拼生成链
基础链:检索结果拼成上下文,连同问题一起过 Prompt、LLM、输出解析。
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain_core.output_parsers import StrOutputParser

template = """请根据以下上下文信息来回答问题。如果你不知道答案,就说你不知道,不要试图编造答案。
用最多三句话来回答,并保持答案简洁。

上下文:
{context}

问题: {question}

有用的回答:"""
prompt = ChatPromptTemplate.from_template(template)

def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)

rag_chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)

answer = rag_chain.invoke("Langchain 的核心组件有哪些?")
print(answer)
拆开看这条链:输入是问题字符串,RunnablePassthrough() 把它原样传给 question;retriever | format_docs 表示先用检索器取文档、再拼成字符串赋给 context;然后依次过 Prompt、LLM,StrOutputParser() 把模型输出解析成纯字符串。整条链由 | 组合,每一段都是 Runnable,天然支持 .invoke()、流式输出和异步。
想同时拿到源文档做溯源,用 RunnablePassthrough.assign 把中间结果挂在字典里:
from operator import itemgetter

rag_chain_with_source = RunnablePassthrough.assign(
    context=itemgetter("question") | retriever | format_docs
).assign(
    answer=(
        {"context": itemgetter("context"), "question": itemgetter("question")}
        | prompt
        | llm
        | StrOutputParser()
    )
)

result = rag_chain_with_source.invoke({"question": "Langchain 的核心组件有哪些?"})
print(result["answer"])   # 生成的回答
print(result["context"])  # 参与生成的检索原文,可用来核对出处
Prompt 里"不知道就说不知道"这句话值得保留——它是压制幻觉的第一道闸门,尤其在检索没命中、上下文里根本没有答案的时候。
历史写法注记:RetrievalQA
这份教程最初是用 RetrievalQA 写的,0.1 时代的标准做法长这样:
# ⚠️ LangChain 1.0 已移除,仅供对照历史代码
from langchain.chains import RetrievalQA

qa_chain = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",  # 或 "map_reduce" / "refine" / "map_rerank"
    retriever=retriever,
    return_source_documents=True,
)
result = qa_chain.invoke({"query": "请介绍一下 Langchain 的主要功能。"})
print(result["result"])
它把"检索 + 拼 Prompt + 生成"封成一个现成的链,chain_type 决定文档的塞法:stuff 全部塞进一个 Prompt;map_reduce 分块各自作答再合并;refine 逐块迭代修正;map_rerank 分块作答后按置信度挑。当年确实好用,我的 main.py 里跑通的也是它。
LangChain 1.0 把 langchain.chains 里这批 legacy 链整体移除了,RetrievalQA 已不存在。现代等价物就是上文那几行 LCEL——十行不到,换来的是每一步可插拔可调试;要接 Agent 的话,用 create_retrieval_tool 把检索器包成工具交给模型自主调用。老代码迁移时,遇到 from langchain.chains import RetrievalQA 直接按上文重写即可。
进阶检索策略
基础 RAG 跑通后,瓶颈多半出在检索而不是生成。三个常用升级:
MMR:解决"检索回来的块都长一个样"
普通 top-k 检索常返回几个彼此高度相似的块,占满上下文却没带来新信息。MMR(Maximal Marginal Relevance)在"与查询相似"和"彼此不相似"之间做平衡,迭代选点。启用只需换参数:
retriever = vectorstore.as_retriever(
    search_type="mmr",
    search_kwargs={"k": 4, "fetch_k": 20, "lambda_mult": 0.5},
)
fetch_k 是参与 MMR 挑选的候选数(应大于 k),lambda_mult 越接近 1 越偏多样性、越接近 0 越偏相似度。
MultiQueryRetriever:用 LLM 改写查询
用户的提问措辞常常和文档措辞对不上,一路查询召回有限。MultiQueryRetriever 让 LLM 把一个问题从不同角度改写成多个查询,分别检索后合并去重,提升召回:
retriever_multiquery = MultiQueryRetriever.from_llm(
    retriever=vectorstore.as_retriever(search_kwargs={"k": 1}),
    llm=llm,
)
代价是每次检索多一次 LLM 调用,适合召回率明显不足时再上。
SelfQueryRetriever:语义检索 + 元数据过滤
文档带结构化元数据(来源、类别、日期)时,SelfQueryRetriever 用 LLM 把自然语言拆成"语义查询 + 元数据过滤条件"两部分,向量库里同时做相似度和过滤。“找水果相关的文档,只要 doc3 来源的"这类需求,普通向量检索表达不出来,它能。
用法上需要用 AttributeInfo 把元数据字段的名称、类型、描述告诉 LLM,再 SelfQueryRetriever.from_llm(llm=..., vectorstore=..., metadata_field_info=[...]) 构建,且向量库必须支持元数据过滤(Chroma 支持)。
同一方向上还有几个值得知道的名字:ContextualCompressionRetriever(检索后用 LLM 过滤或抽取相关片段,给上下文瘦身)、EnsembleRetriever(多路召回 + RRF 融合,比如 BM25 和向量各一路)、ParentDocumentRetriever(小块检索保精度、返回父块保上下文完整)。检索质量还有两个进阶手段:混合检索(关键词 + 向量)和对 top-k 结果做 Rerank 重排。不用一次全上,哪个指标差修哪个。
怎么知道 RAG 好不好:评估指标
调优之前先有度量,否则改 chunk_size、换嵌入模型全是凭感觉。RAG 的质量要拆成两层看:检索层(该找到的找到了吗)和生成层(找到的材料用对了吗)。两层修法完全不同——检索差该动分割策略和嵌入模型,生成差该动 Prompt 和模型——混在一起调是常见错误。
| 层 | 指标 | 衡量什么 |
|---|---|---|
| 检索 | Hit Rate | top-k 结果里包含正确文档的比例 |
| 检索 | MRR | 正确文档排名倒数的平均(第 1 名得 1,第 3 名得 1/3) |
| 检索 | Precision@k / Recall@k | 返回的 k 条里有多少相关 / 该找到的找到了多少 |
| 检索 | nDCG@k | 带排名位置权重的列表质量 |
| 生成 | EM(Exact Match) | 答案与标准答案完全一致的比例 |
| 生成 | F1 | 答案词级精确率/召回率的调和平均,适合抽取式问答 |
| 生成 | BLEU / ROUGE / METEOR | 生成文本与参考答案的重叠度,适合开放式生成 |
| 生成 | 语义相似度 | 用嵌入模型算答案与参考答案的向量相似度 |
评估方式从贵到便宜排:
- 人工评估:质量的金标准,准但不可规模化。
- LLM-as-judge:让一个强模型按准确性、相关性、忠实度等维度给答案打分,便宜可规模化,但有自己的偏差(比如偏好长答案),结论要抽检校准。
- 框架:Ragas 专做 RAG 评估,把忠实度(faithfulness)、答案相关性、上下文精确率/召回率等指标现成化;LangSmith 提供数据集管理、运行评估和版本对比。
这些指标都依赖一个带标准答案的测试集(问题 + 正确出处 + 参考答案)。没有测试集,任何指标都算不出来——这也是多数团队跳过评估的原因。哪怕手工整理二十个有代表性的问题,也够支撑第一轮迭代。
总结
一条 RAG 主线至此完整:加载 → 分割 → 嵌入 → Chroma 落库 → 检索 → LCEL 生成,百炼的模型用 OpenAI 兼容模式接入,一套 langchain-openai 通吃。下一步可以按顺序做这几件事:
- 把
main.py里的老写法按本文修正(langchain_text_splitters导入、invoke()、去掉persist()、RetrievalQA 换 LCEL),在当前版本的 LangChain 上重跑一遍。 - 用同一组问题对比不同
chunk_size/chunk_overlap下的检索质量,别沿用默认值。 - 检索结果重复单一时,先把
search_type换成"mmr",这是成本最低的升级。 - 整理一批带标准答案的测试问题,用 Hit Rate / MRR 或直接上 Ragas 建立基线,之后的每次改动都对着基线说话。
- 需要更精细的召回再考虑 MultiQuery / SelfQuery,需要接 Agent 用
create_retrieval_tool。
进一步阅读:LangChain 官方文档 https://python.langchain.com/