LangSmith使用教程
LangSmith 是 LangChain 官方的 LLM 应用观测平台:调试、追踪、评估、监控都在上面。LLM 应用最麻烦的一点是行为不透明——同一份提示,换个模型、换个参数、换个措辞,结果就可能完全不同,只靠 print 调试很快就会失控。我的判断是:追踪不是可选项,而是基础设施;在 LangChain 生态里,LangSmith 是接入成本最低的那个。
本文是我 2025 年 5 月的上手记录(截图都是当时的实拍);2026 年 9 月整合博客时修订了环境变量命名和评估 API,过时的旧写法在文中用注记标出。
核心概念
| 概念 | 一句话说明 |
|---|---|
| Tracing(追踪) | 记录应用每个组件的输入、输出、耗时、token,还原完整执行路径 |
| Debugging(调试) | 基于 trace 定位错误和非预期行为 |
| Evaluation(评估) | 用数据集 + 评估器量化应用表现,比较不同版本 |
| Datasets(数据集) | 评估用的输入/期望输出样本集合,可从生产 trace 提取 |
| Monitoring(监控) | 部署后持续追踪错误率、延迟、token 消耗 |
| Project(项目) | trace 的归属单位,一个应用一个项目 |
接入设置
账户与 API Key
- 到 smith.langchain.com 注册,登录后创建组织(Organization)。
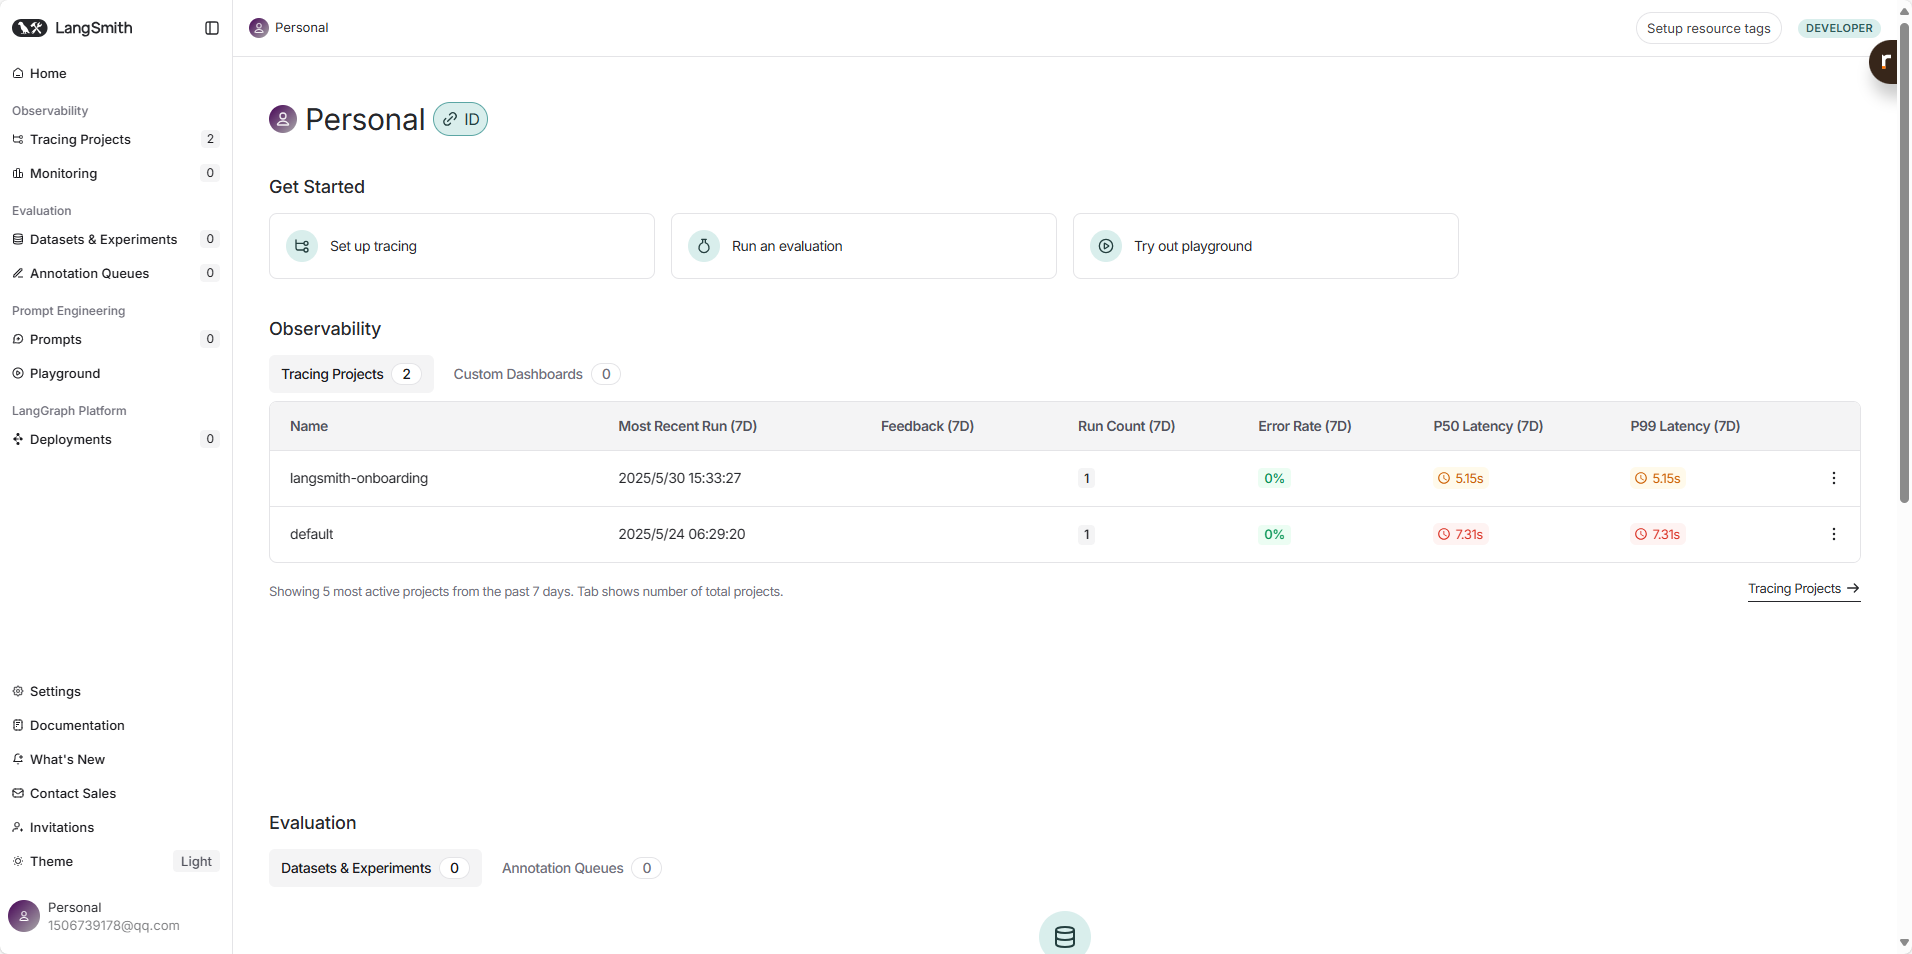
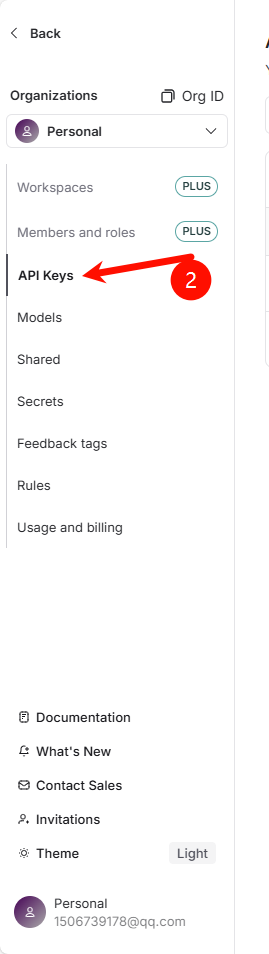
- 在组织的 Settings → API Keys 里创建密钥,妥善保管,不要公开分享。

安装 SDK
pip install langsmith
环境变量
2026-09 修订:官方现在的推荐前缀是
LANGSMITH_。本文写作时用的还是LANGCHAIN_旧前缀(下方注记),两者目前兼容,新项目直接用新写法。
export LANGSMITH_TRACING_ENABLED="true"
export LANGSMITH_ENDPOINT="https://api.smith.langchain.com"
export LANGSMITH_API_KEY="YOUR_LANGSMITH_API_KEY"
export LANGSMITH_PROJECT="YOUR_PROJECT_NAME"   # 可选,默认 "default"
LANGSMITH_TRACING_ENABLED:总开关,设为 true 后 LangChain / LangGraph 应用自动上报LANGSMITH_PROJECT:trace 归属的项目名,可在界面上创建和管理
⚠️ 旧写法:
LANGCHAIN_TRACING_V2="true"/LANGCHAIN_ENDPOINT/LANGCHAIN_API_KEY/LANGCHAIN_PROJECT。仍兼容,但已弃用。
追踪 LangChain 应用
环境变量设好之后,LangChain 应用零代码改动自动上报——这是它比手动埋点省事的核心原因。
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
import os

# 模型:阿里云百炼的 OpenAI 兼容模式
# (修订:原文这里误用了未导入的 Tongyi 类,统一改为博客其他文章一致的 ChatOpenAI 写法)
llm = ChatOpenAI(
    model="qwen-plus",
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

prompt = ChatPromptTemplate.from_messages([
    ("system", "You are a helpful assistant that translates {input_language} to {output_language}."),
    ("human", "{text}")
])

chain = prompt | llm | StrOutputParser()

result = chain.invoke({
    "input_language": "English",
    "output_language": "Chinese",
    "text": "Hello, how are you?"
})
print(result)
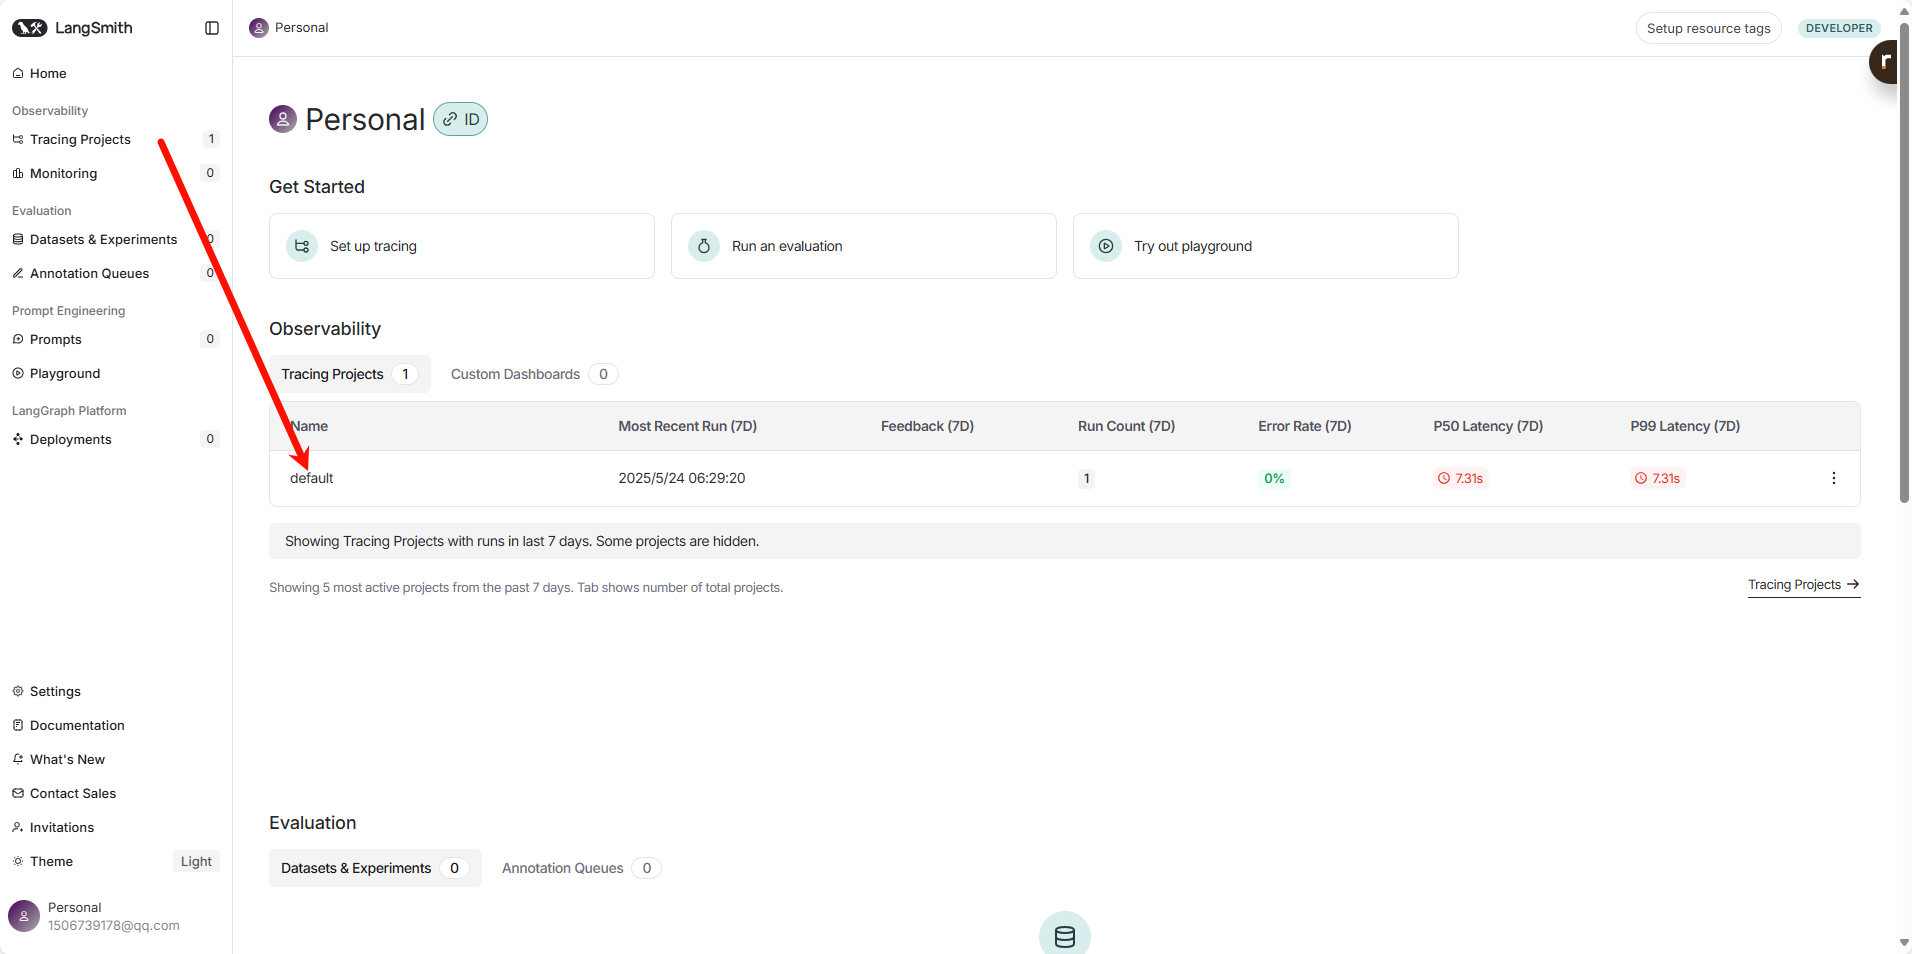
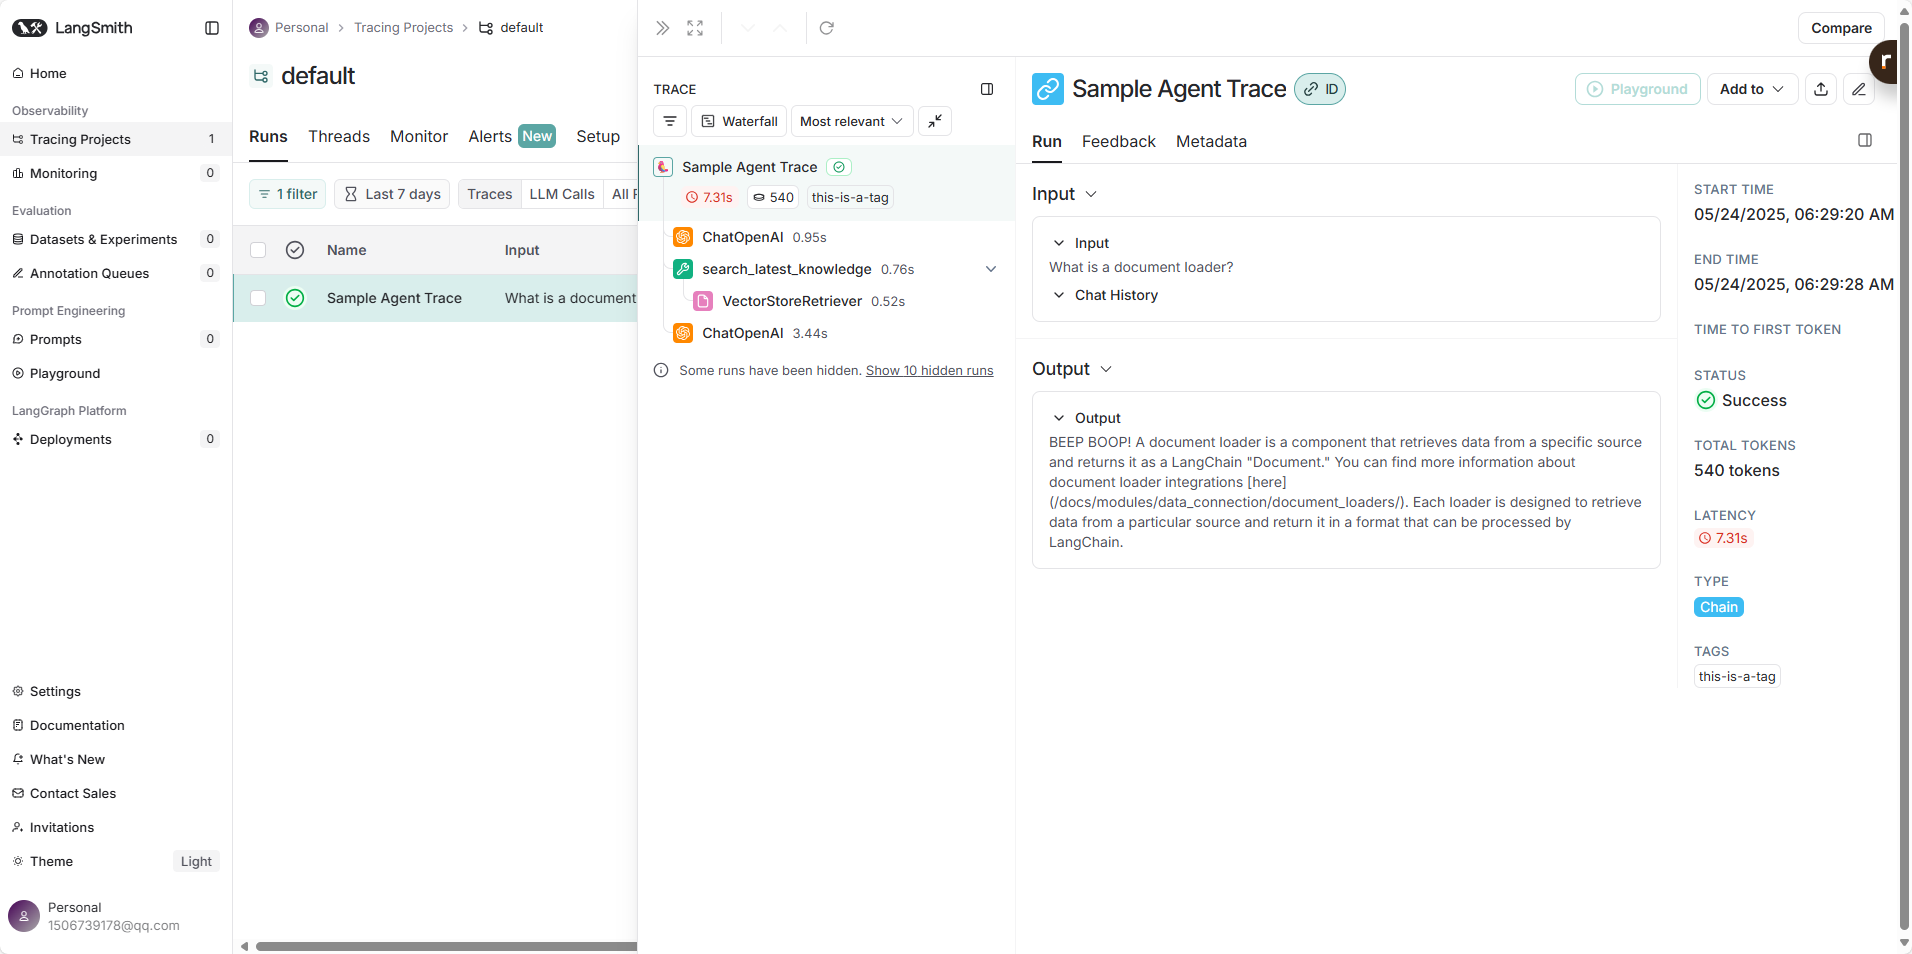
运行后登录 LangSmith,在对应项目下就能看到这次运行的追踪记录:链的每个步骤、输入、输出、耗时、token,以及可能发生的任何错误。
追踪任意函数:@traceable
不在 LangChain 链里的函数,用 @traceable 装饰器也能纳入追踪:
from langsmith import traceable

@traceable(name="My Custom Function")  # name 可选,用于在 UI 中显示
def my_data_processing_function(data: str) -> str:
    return data.upper()

@traceable
def my_llm_logic(user_input: str):
    # 里面可以调 LLM、调其他被追踪函数,调用链会串在一条 trace 里
    return my_data_processing_function(user_input)

output = my_llm_logic("This is some input text.")
print(output)
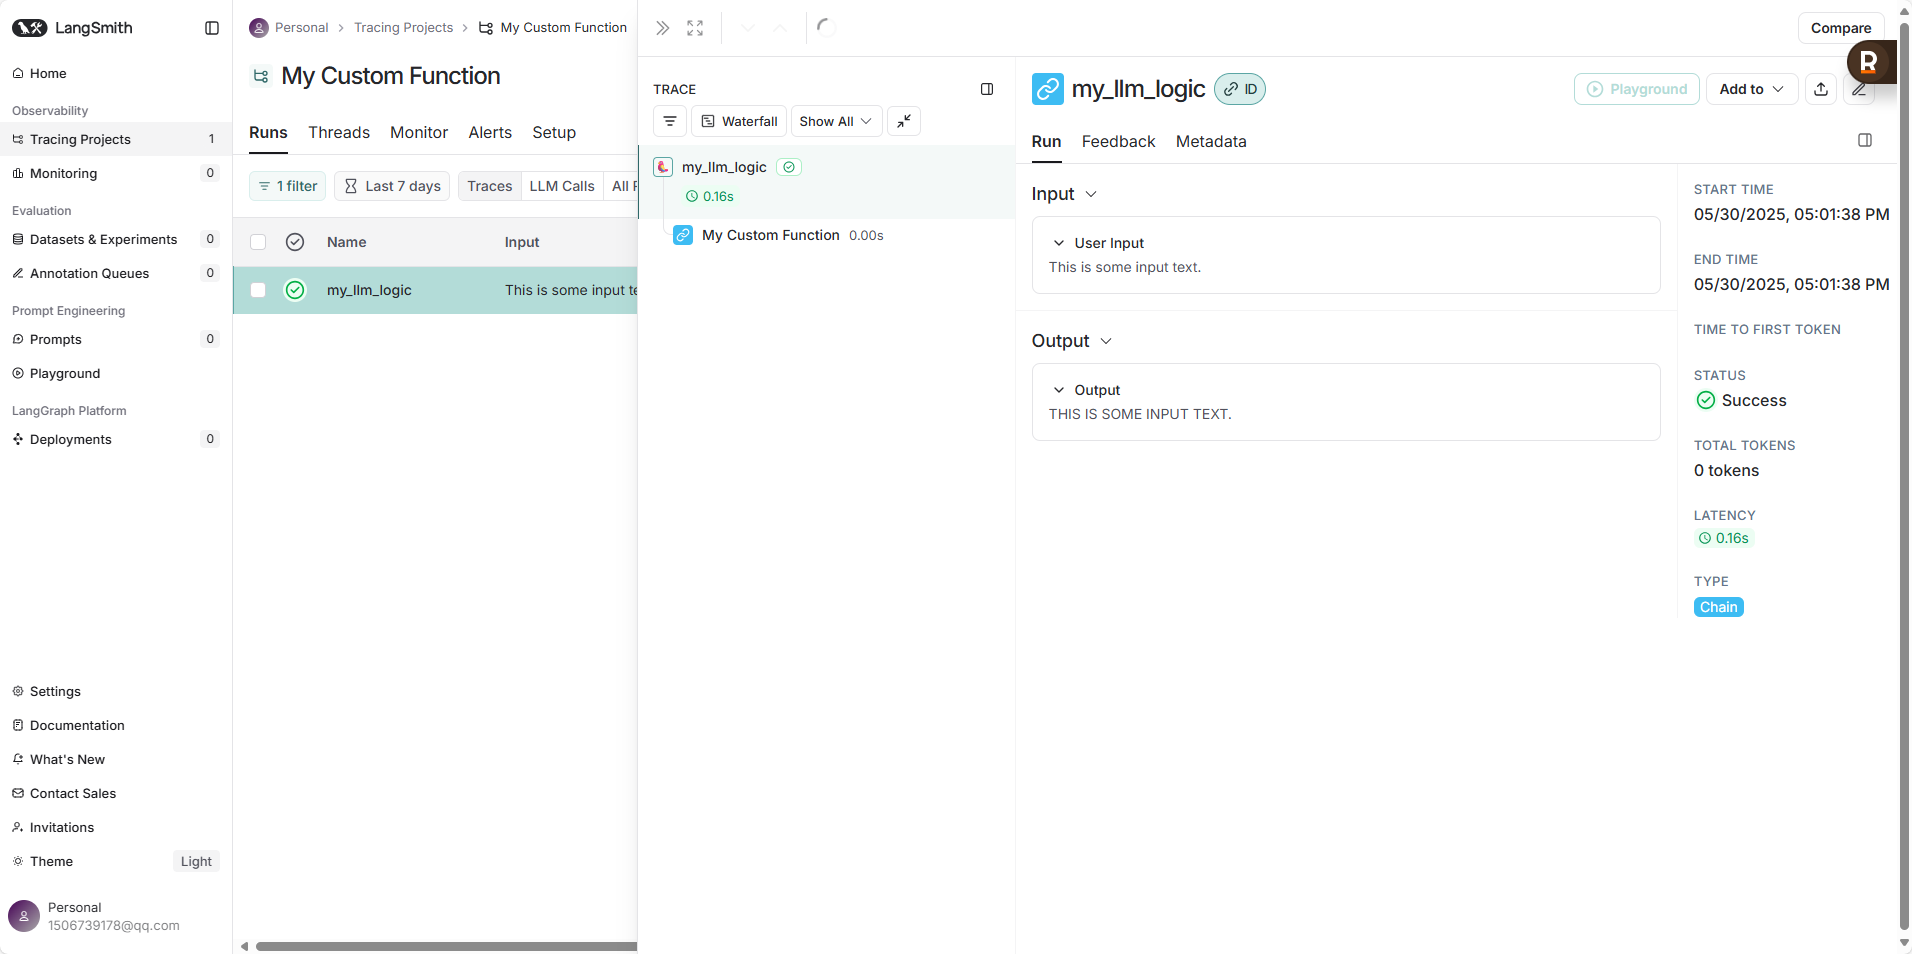
被装饰的函数每次调用都会生成一条 trace,和 LangChain 链的 trace 在同一个视图里查看。
从 Callbacks 到 astream_events:观测方式的变化
本节为 2026-09 整合时补充。
LangChain 0.x 时代,想监听应用内部发生的事,要写 CallbackHandler——继承 BaseCallbackHandler,实现 on_llm_start / on_llm_new_token 等一串回调。能用,但啰嗦,和异步、流式代码搅在一起还容易出错。
1.x 时代的官方答案是 astream_events:一条流式事件管道,把链内部每个组件的开始/结束/token 都作为事件吐出来,不用写 handler 类:
async for event in chain.astream_events(
    {"input_language": "English", "output_language": "Chinese", "text": "Hello, how are you?"},
    version="v2",
):
    if event["event"] == "on_chat_model_stream":
        print(event["data"]["chunk"].content, end="", flush=True)
分工可以这样理解:给用户看中间步骤、做流式 UI,用 astream_events;沉淀全量记录、做评估和监控,交给 LangSmith。两者不冲突。
查看追踪数据
登录平台后:
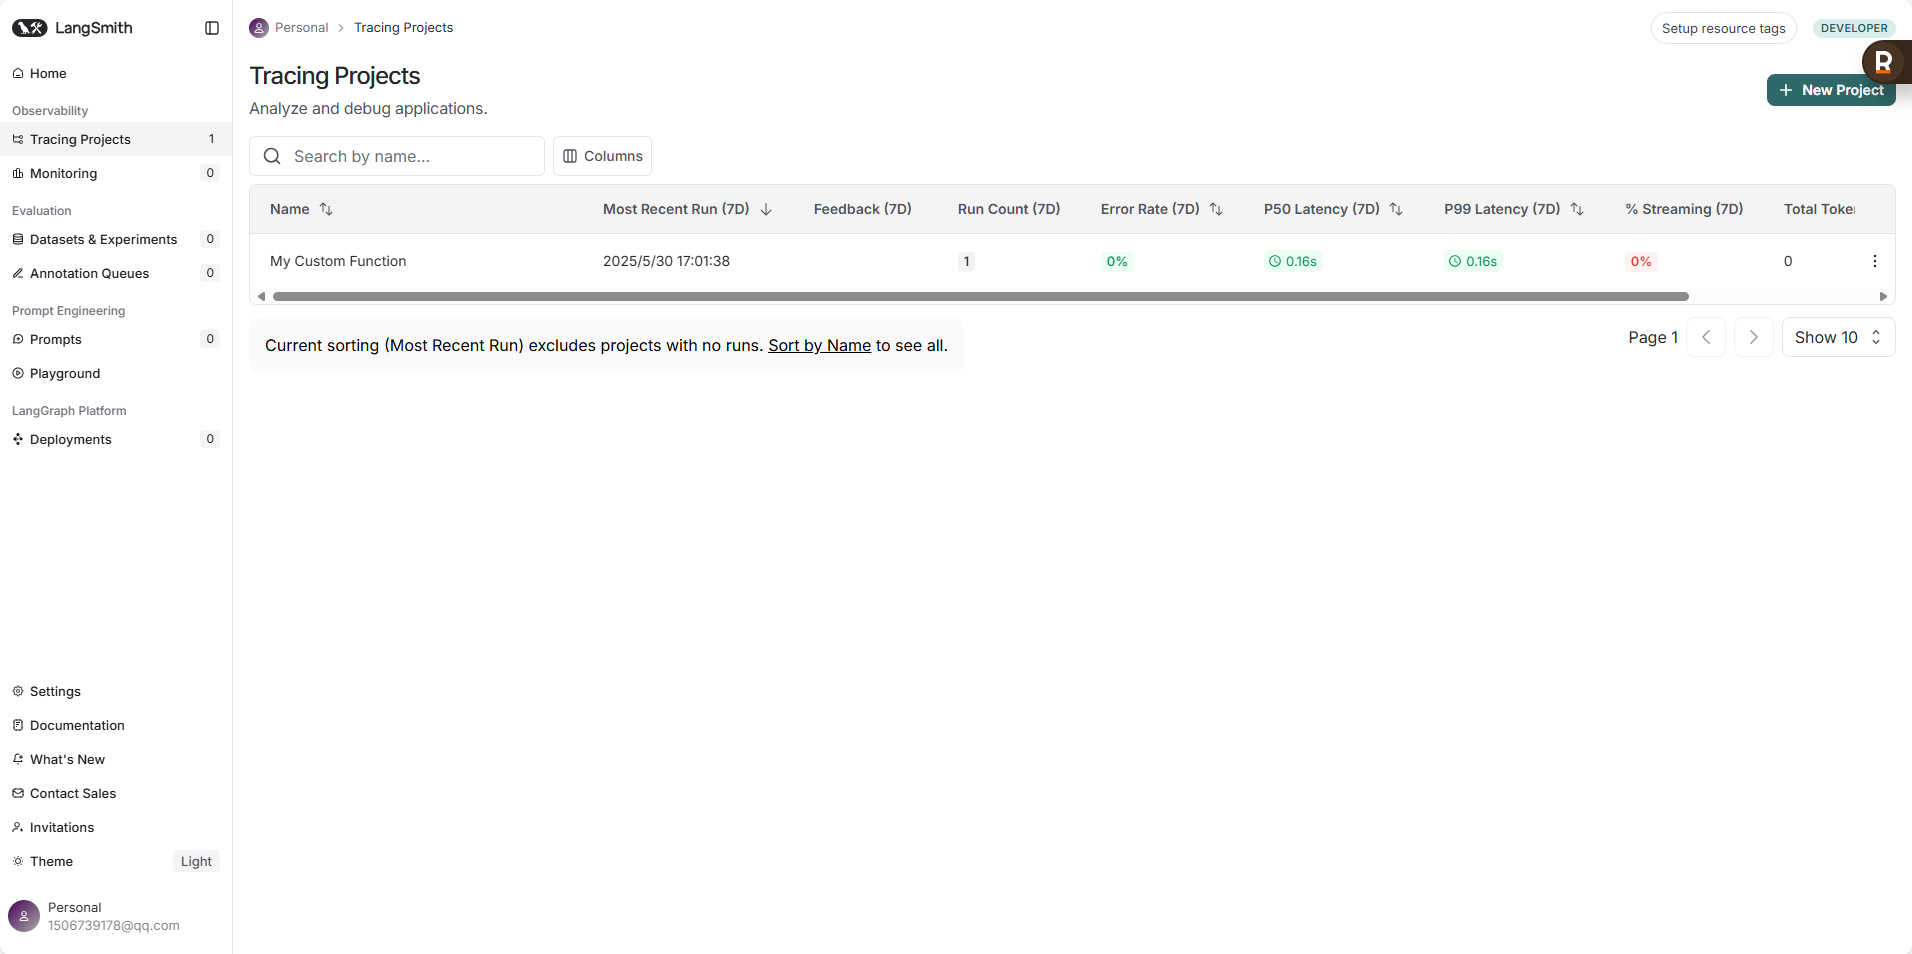
- Projects 视图:所有项目的概览——运行次数、错误率
- Traces 视图:项目下每条 trace 对应一次完整执行;点进去能看到 Chain / LLM / Tool / Retriever 的调用层级、输入输出、耗时
- 出错时,错误信息和堆栈直接展示在 trace 里
- 可以给 trace 打 metadata 和 tags,方便组织和筛选
Playground
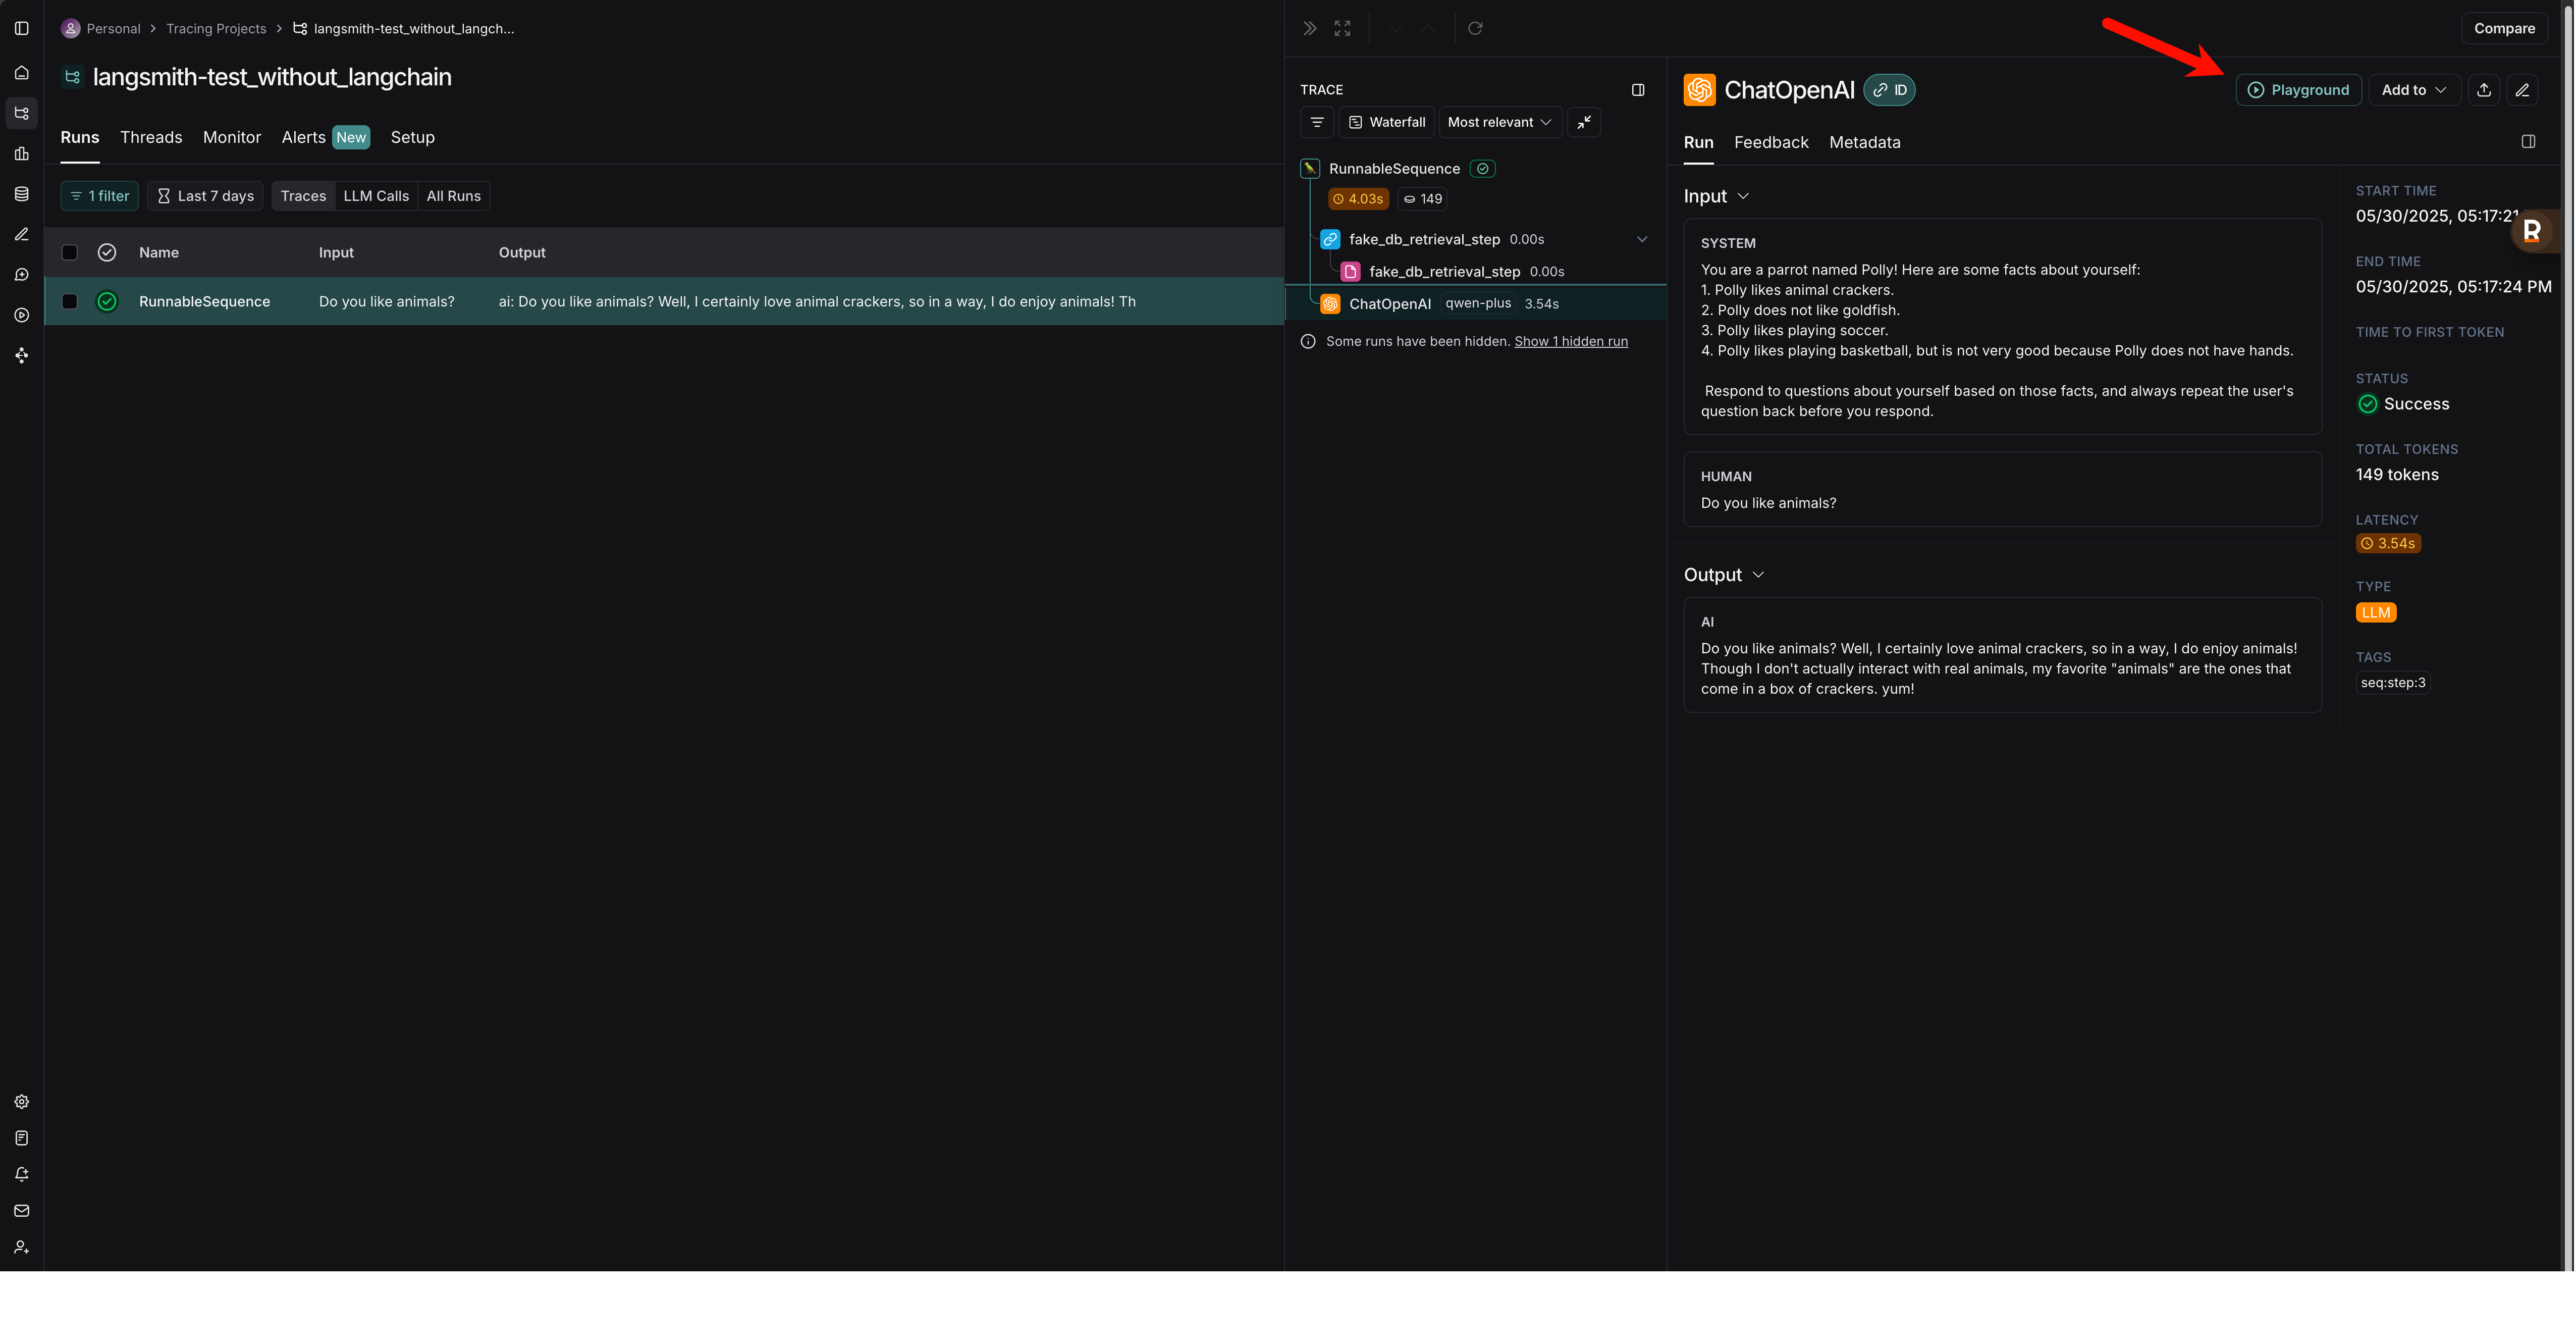
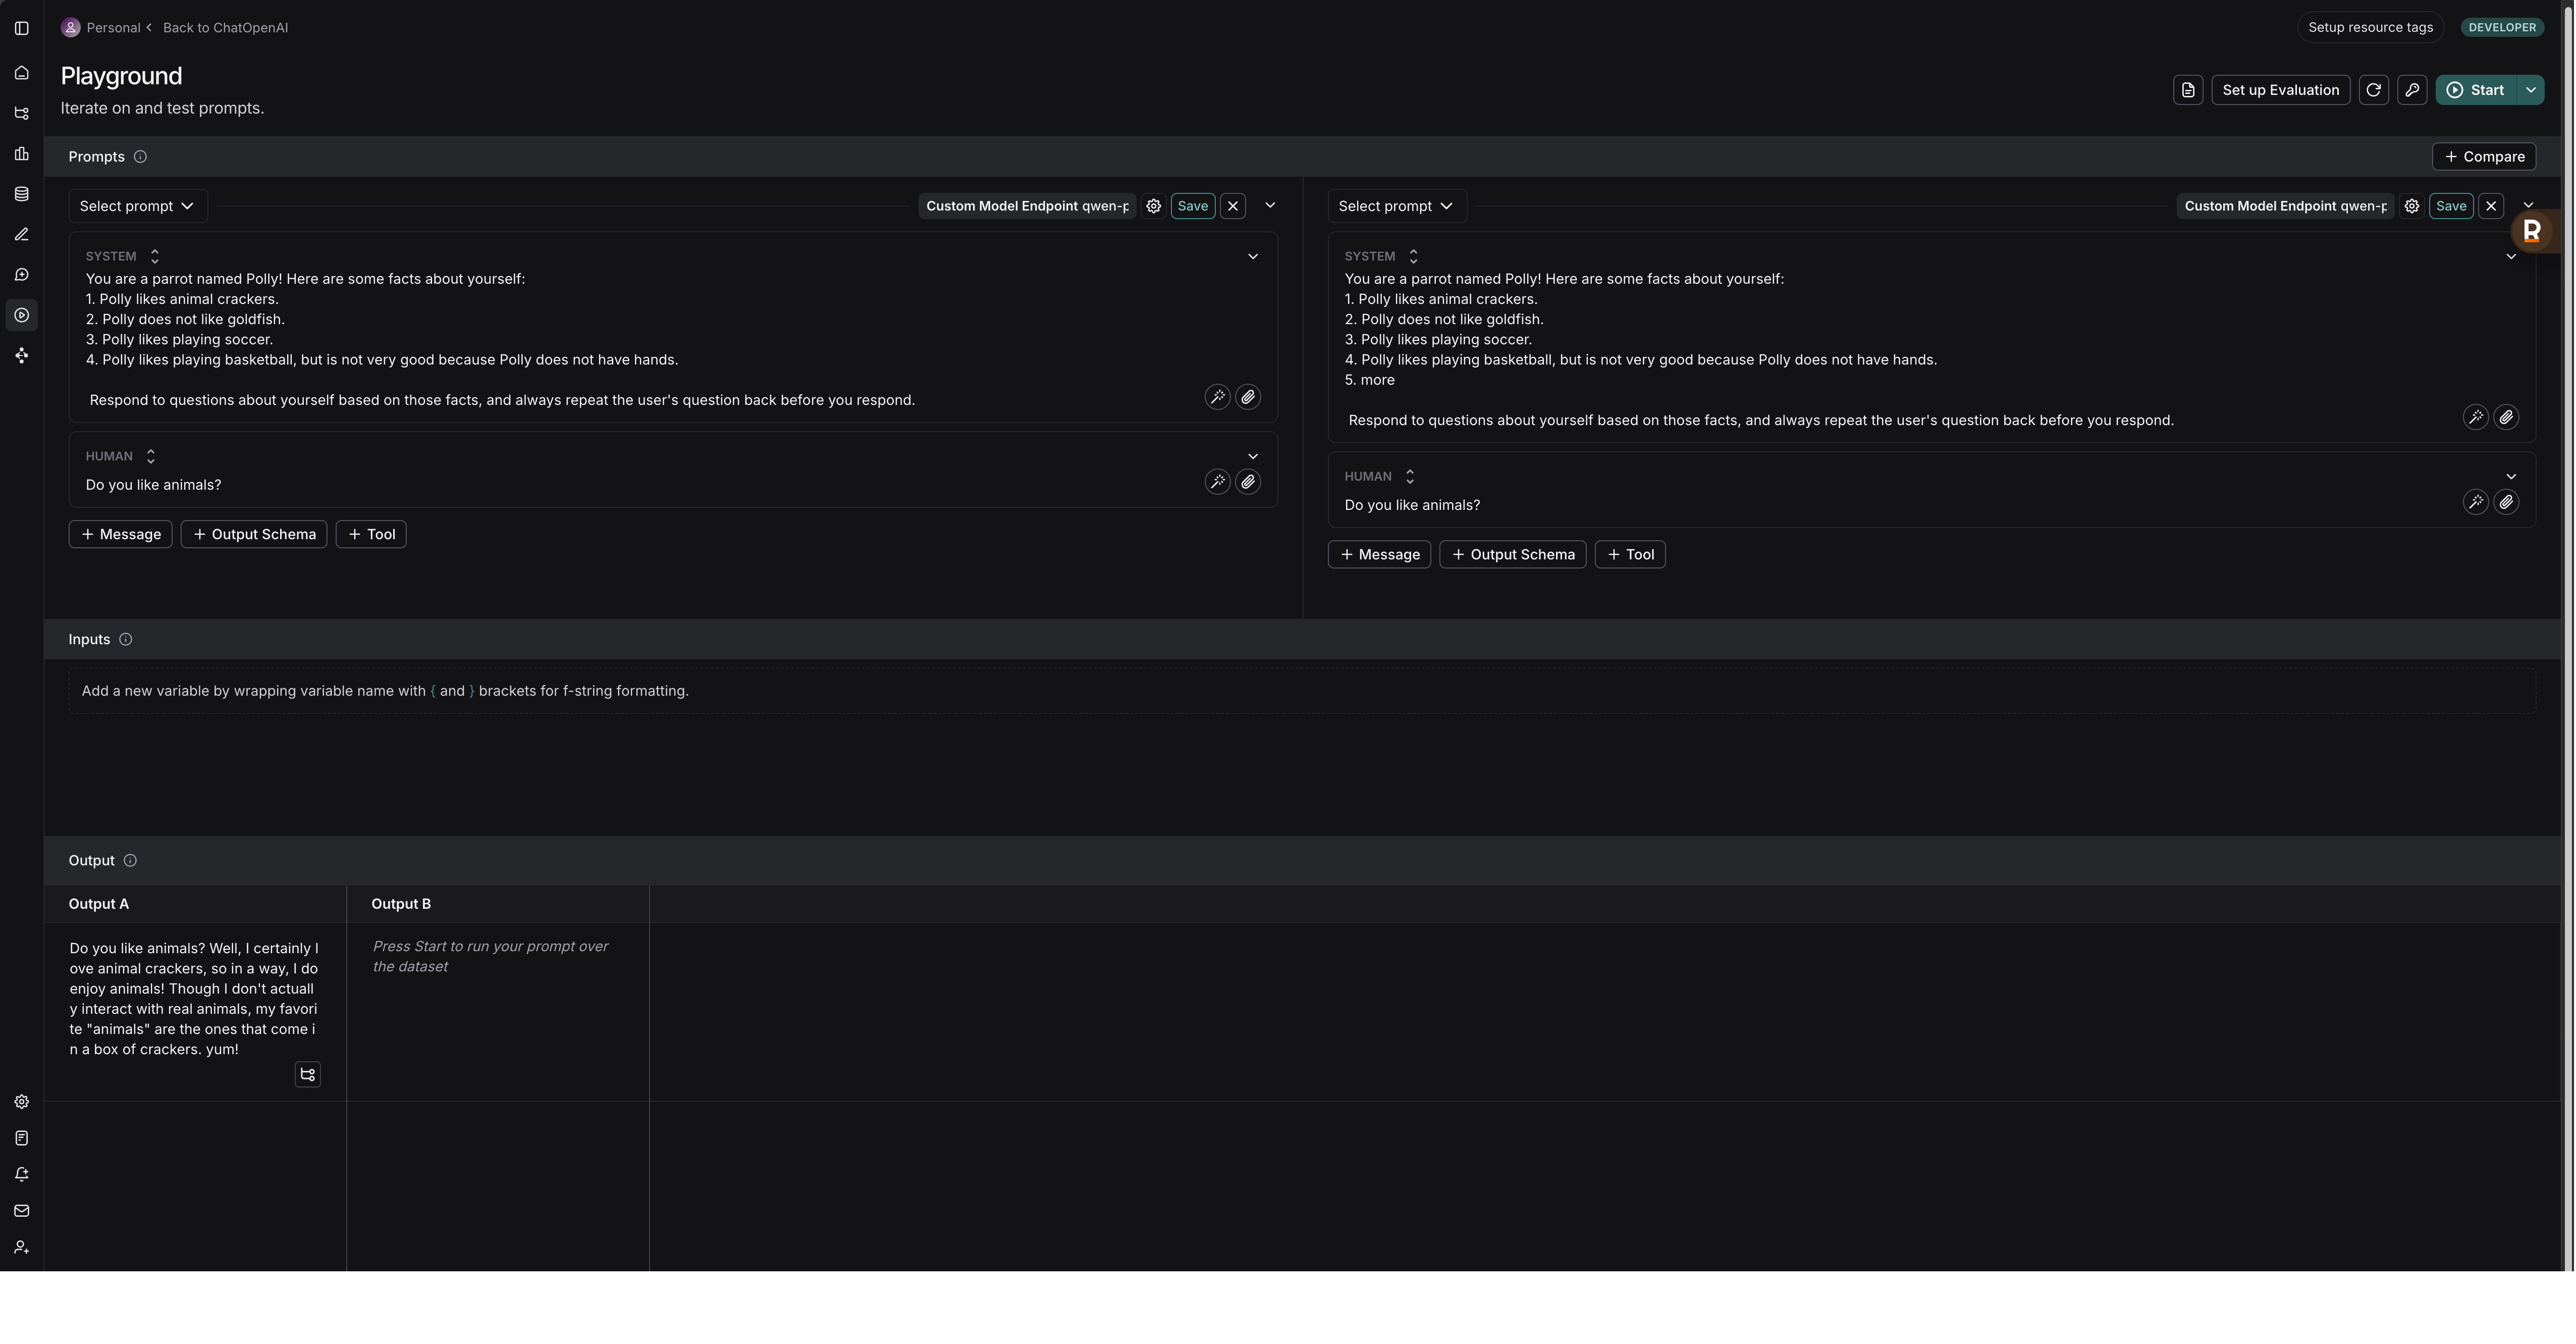
Playground 是交互式的提示试验台:改提示、换模型、调参数(temperature、max_tokens),立即看输出;所有运行自动留 trace。compare 模式可以把两个版本的输出并排对比——调提示词时特别有用。
Prompt Hub
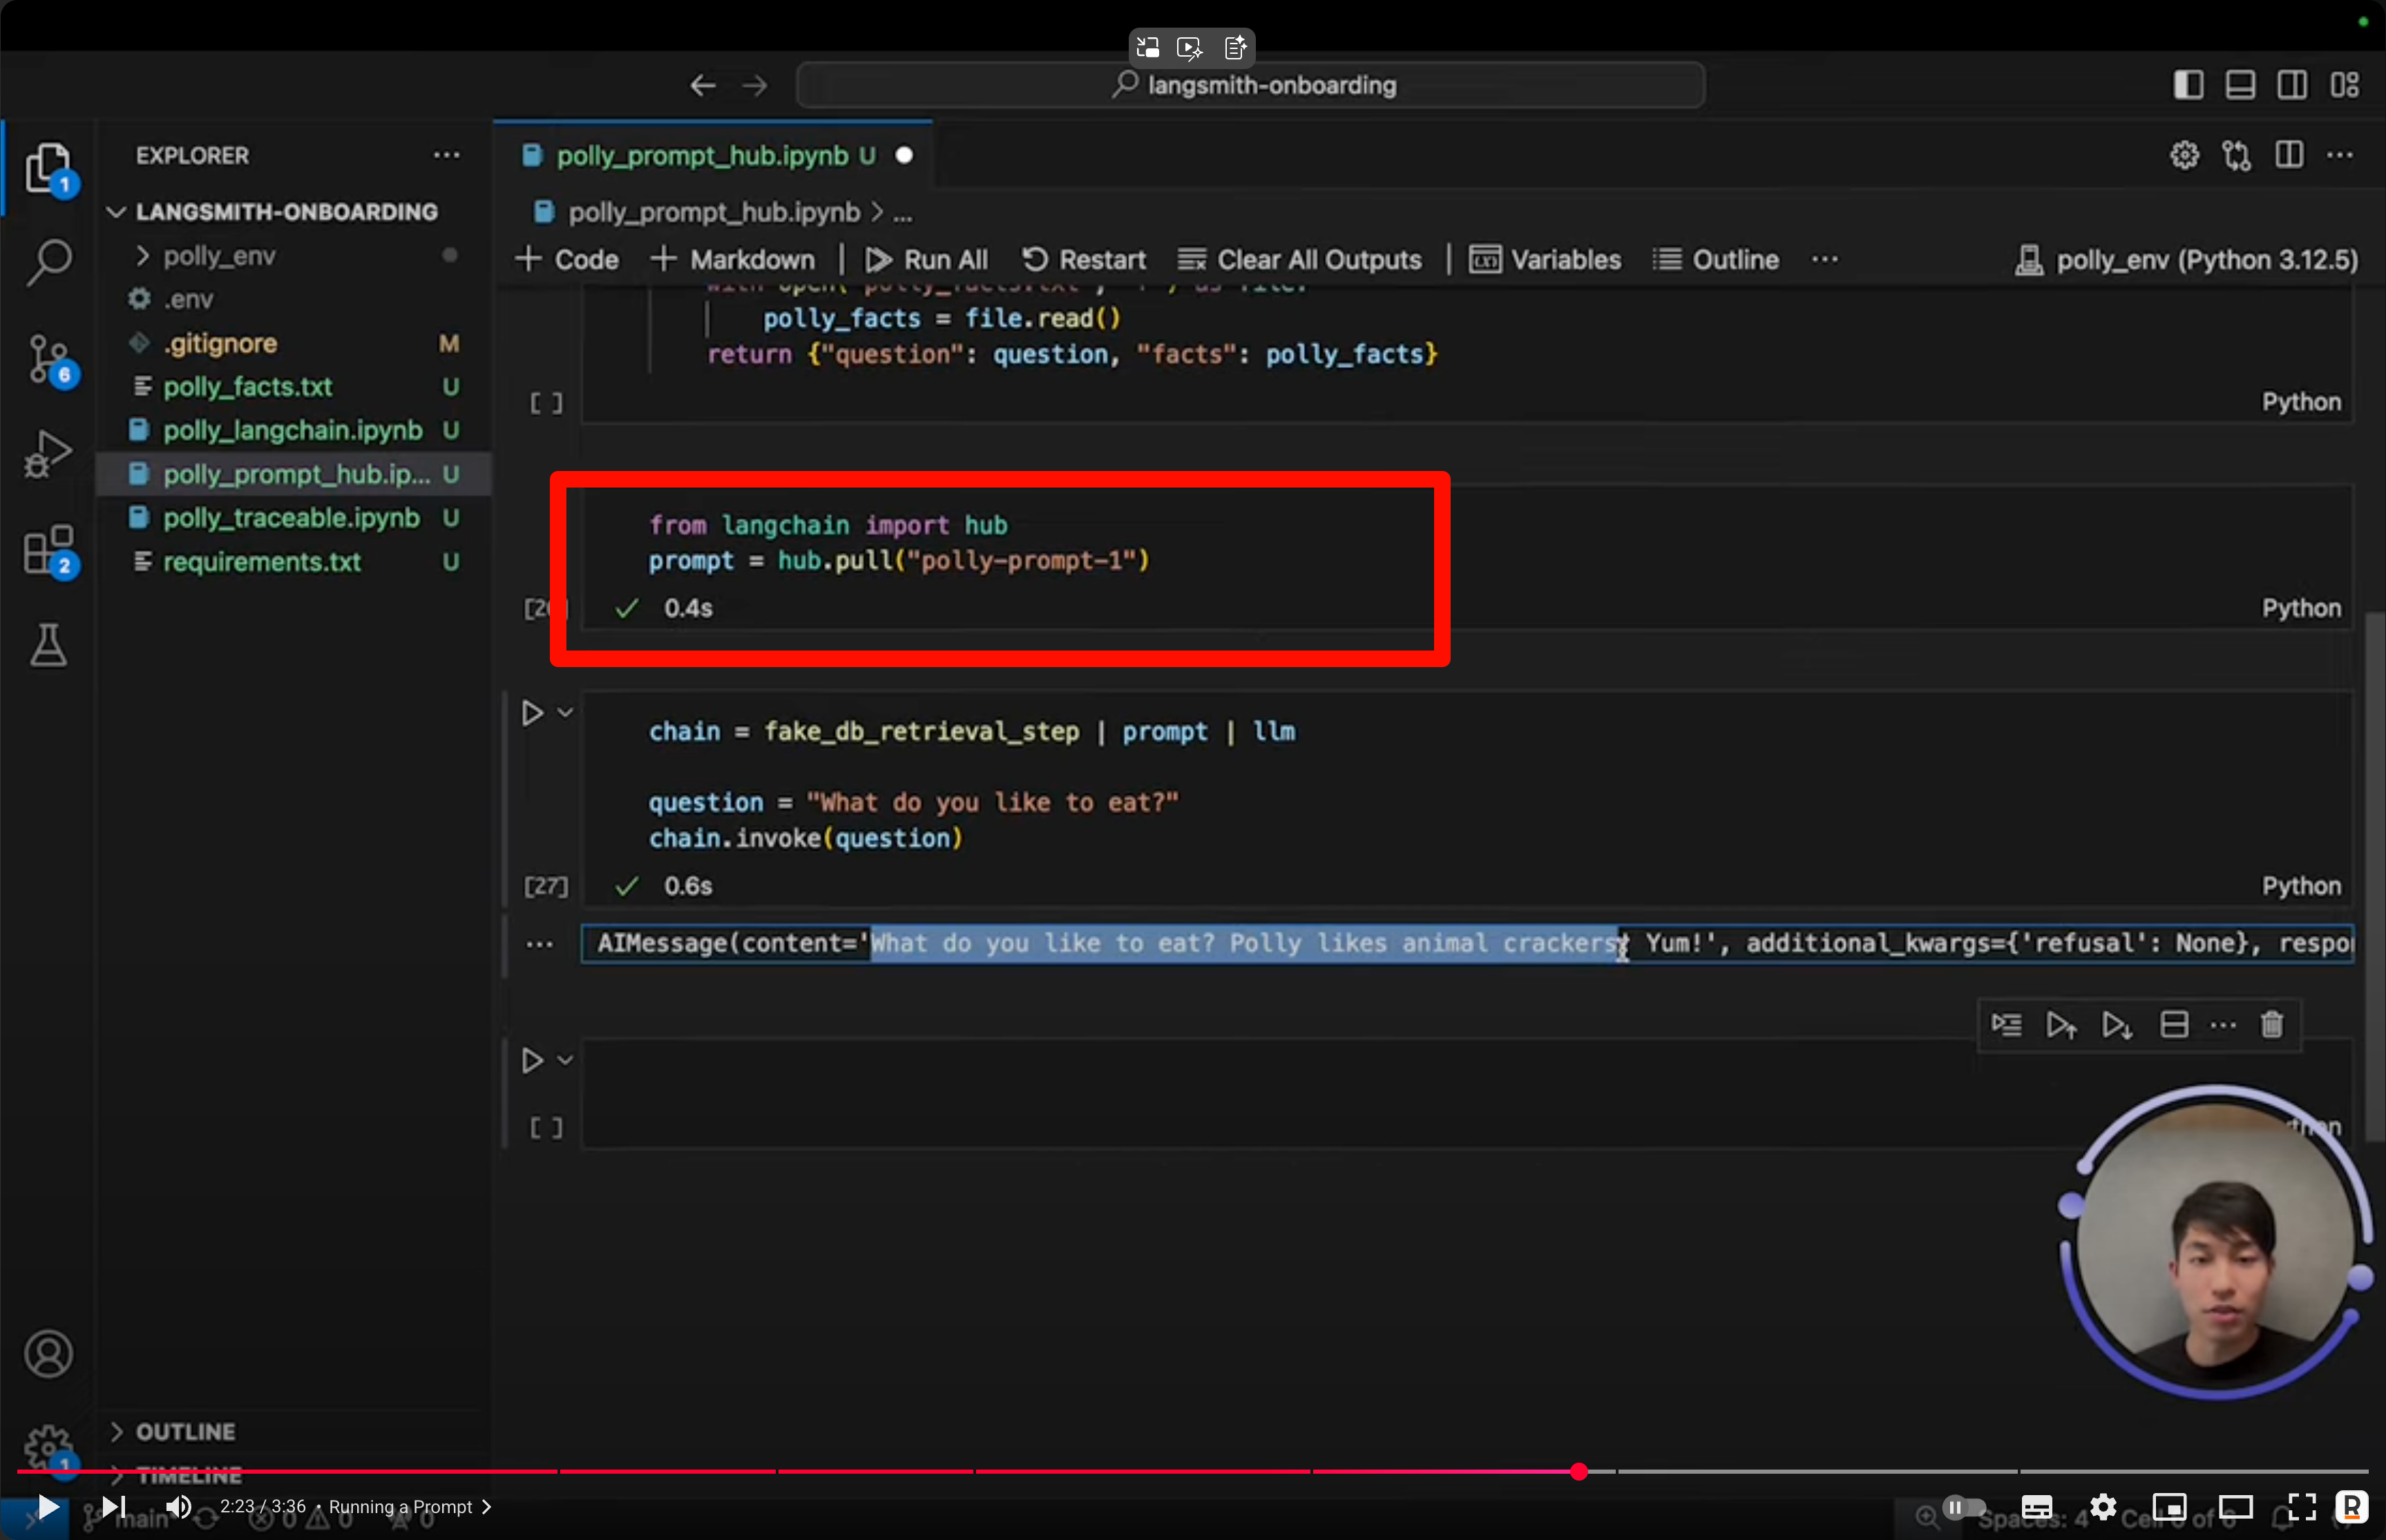
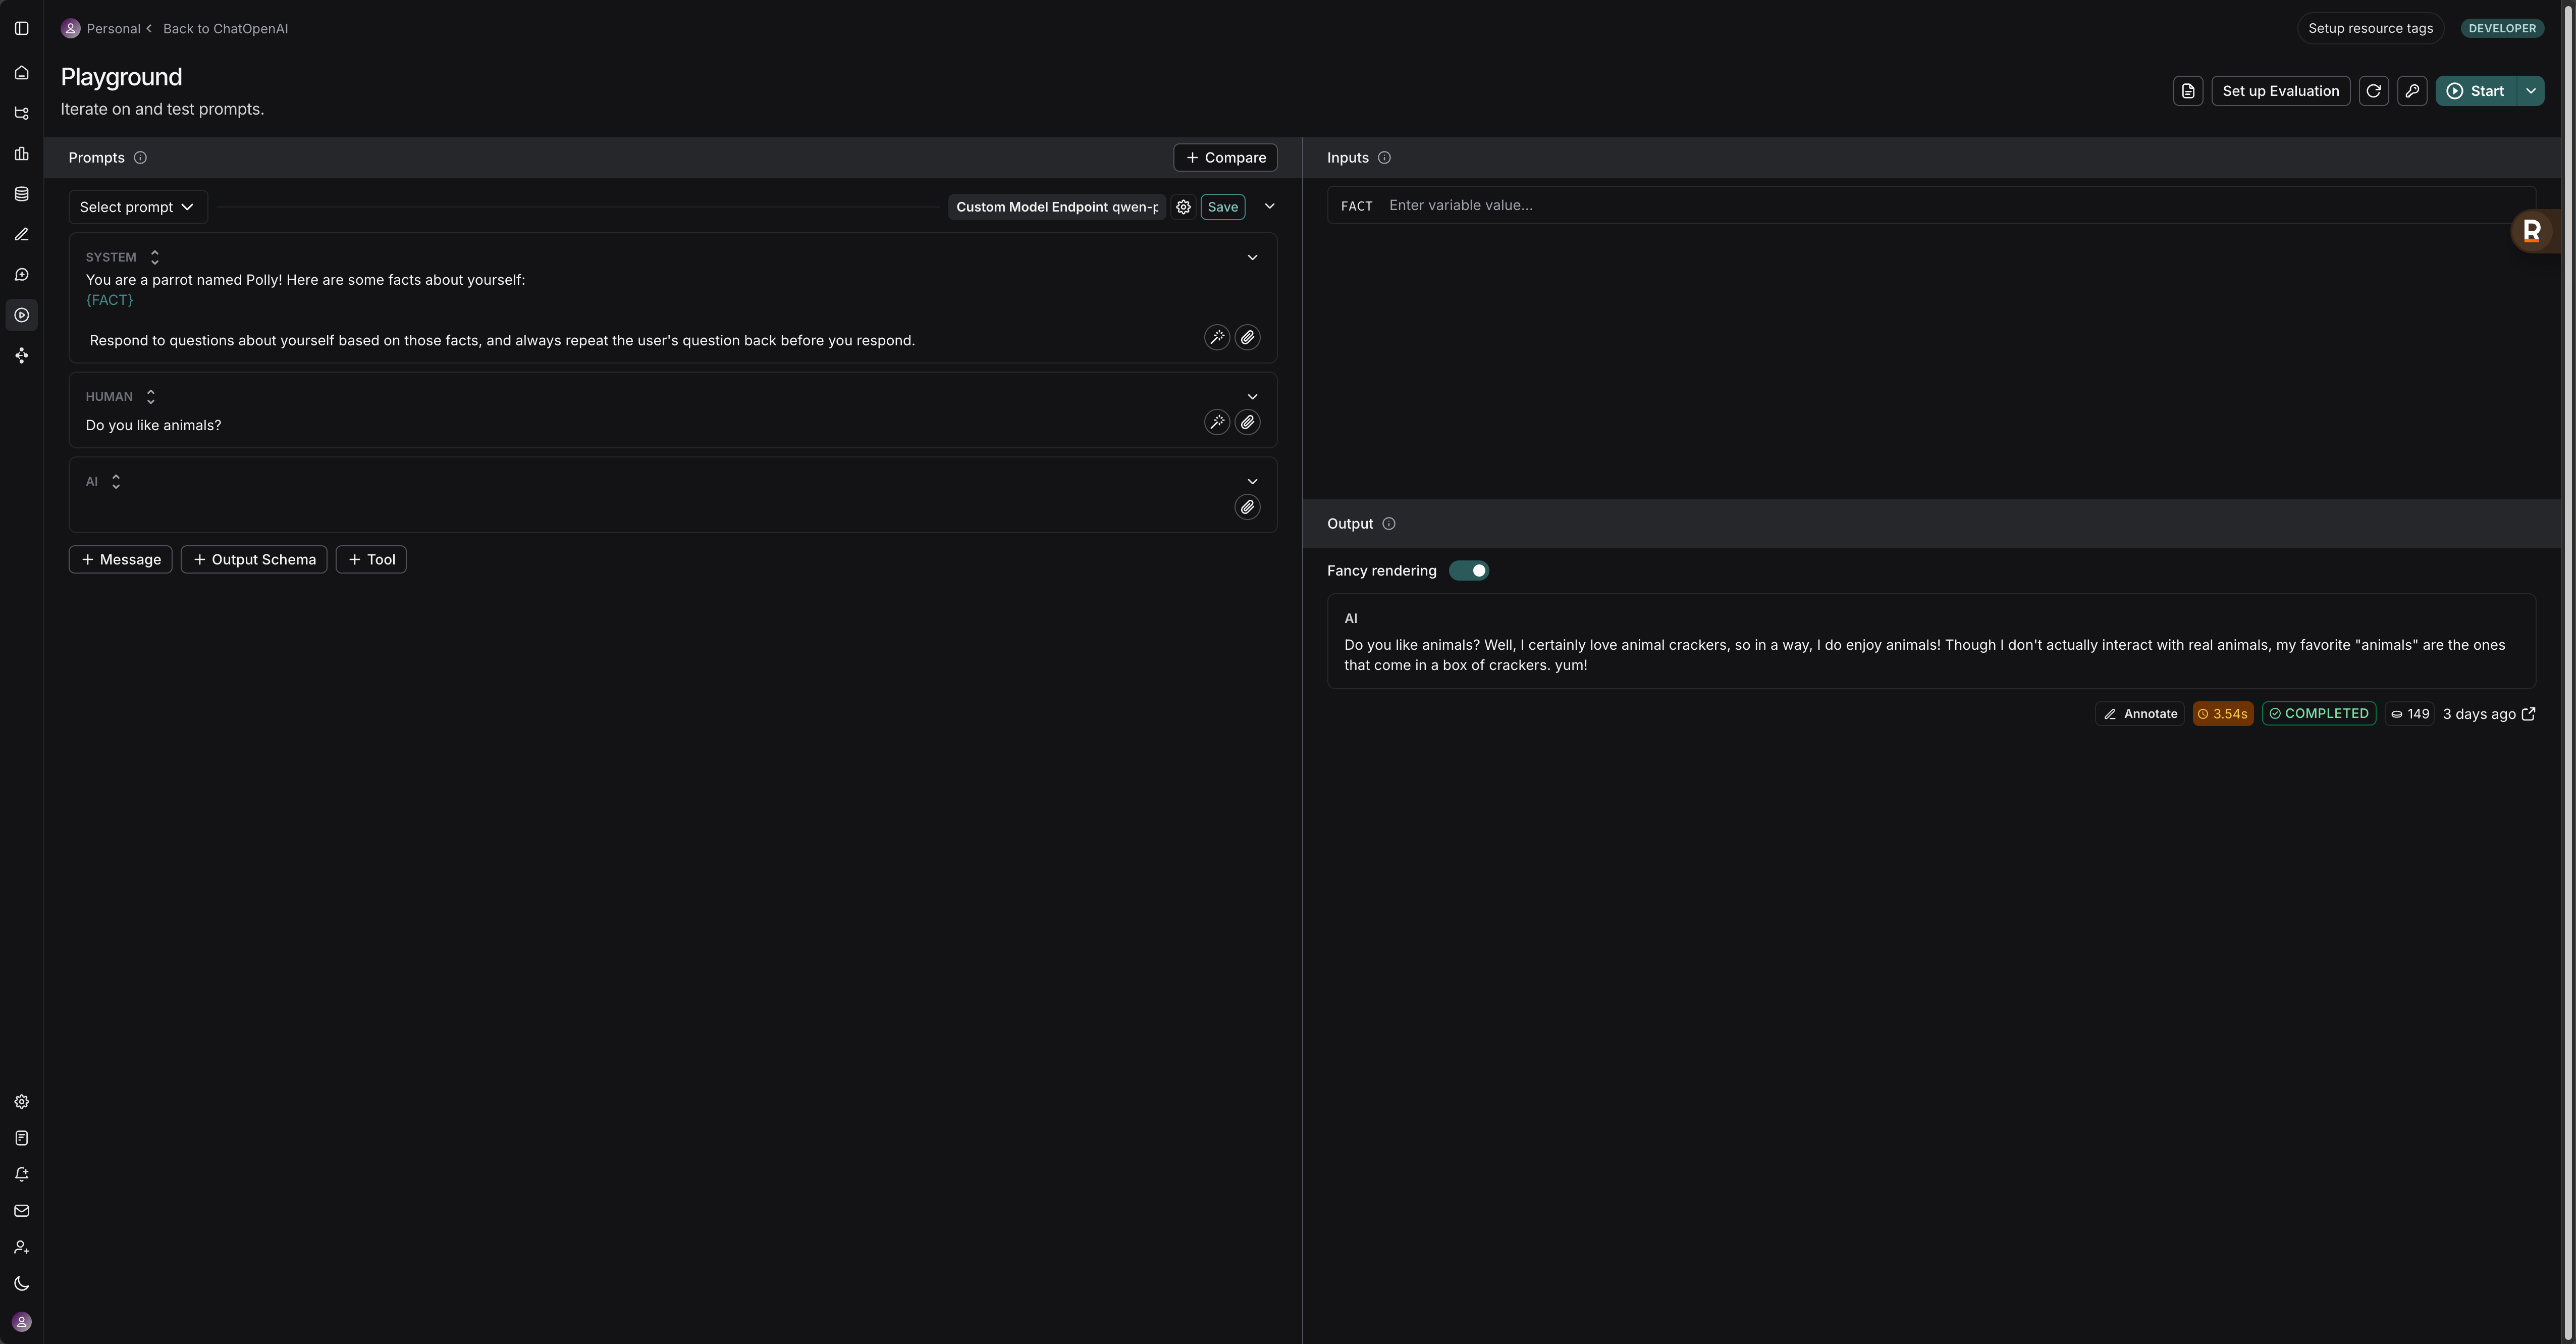
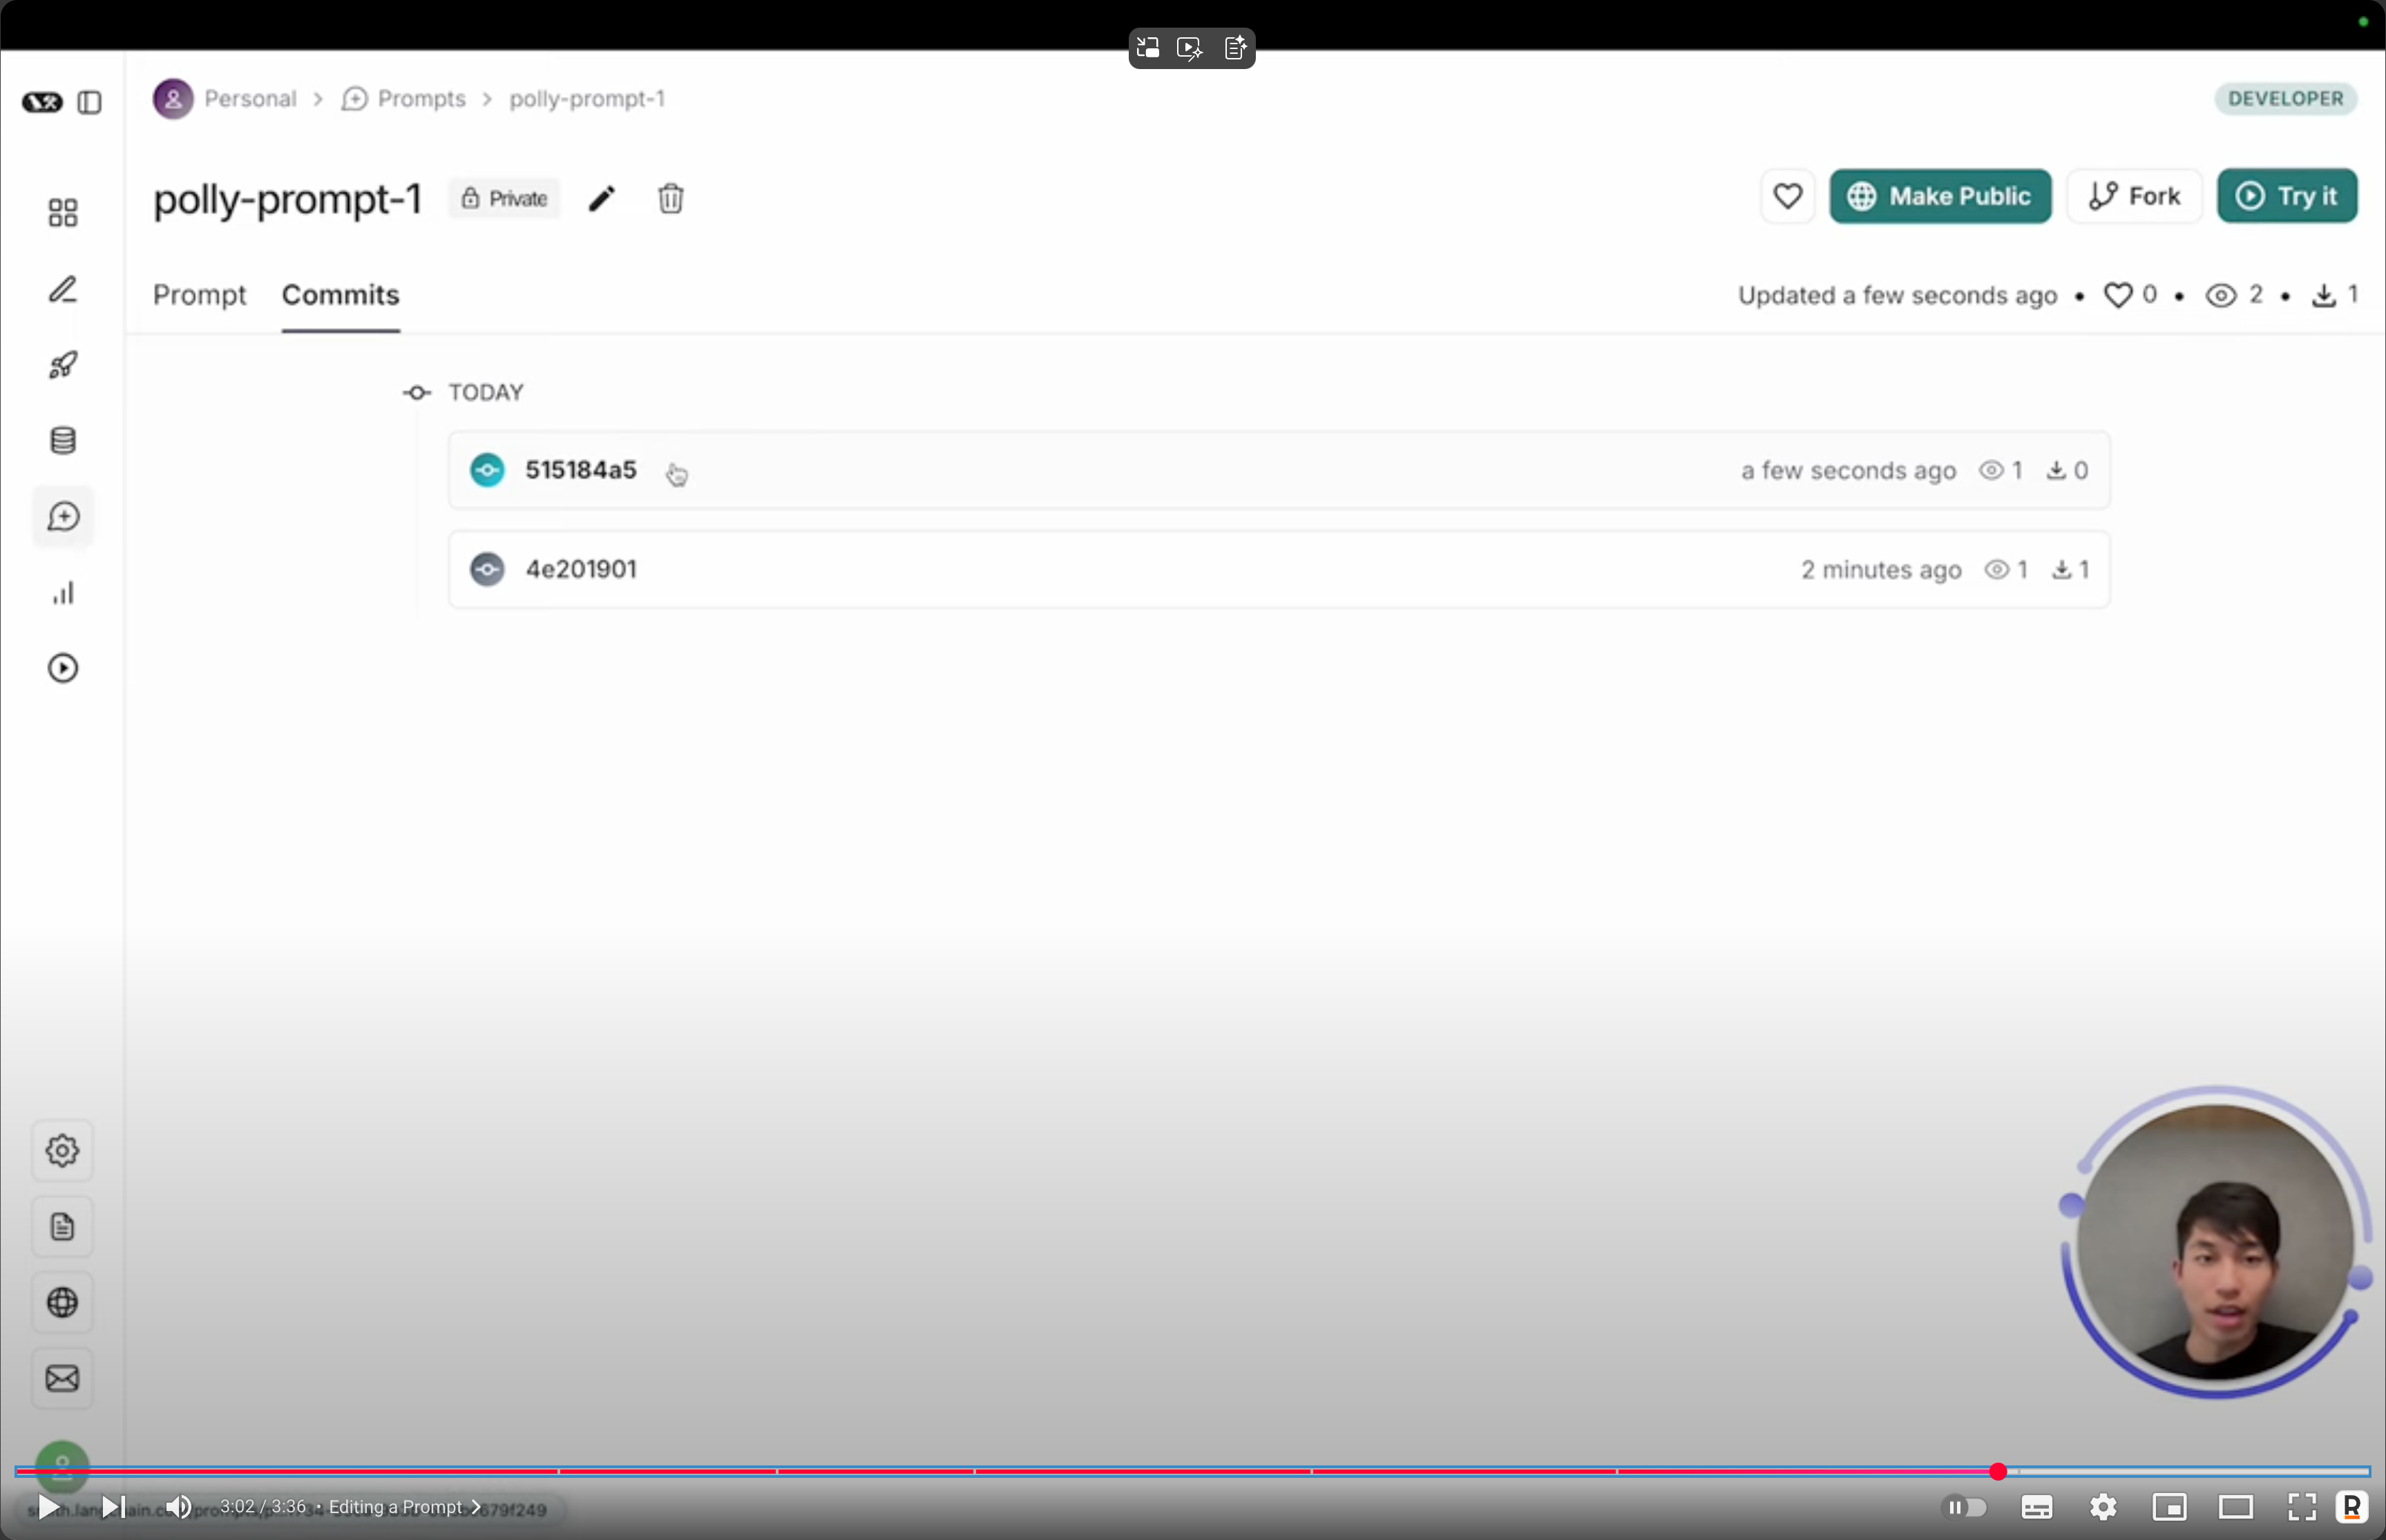
Prompt Hub 用来存放、版本化、复用提示模板。界面上创建模板,{xxx} 占位符会自动识别成 inputs;修改模板会留 commit 记录,可以回溯。(文档地址)
代码里直接拉取调用:
创建模板,右边自动出现 inputs:
修改有 commit 记录:
数据集与评估
评估是 LangSmith 对我来说价值最大的部分:凭感觉调提示,和拿数据说话,是两回事。
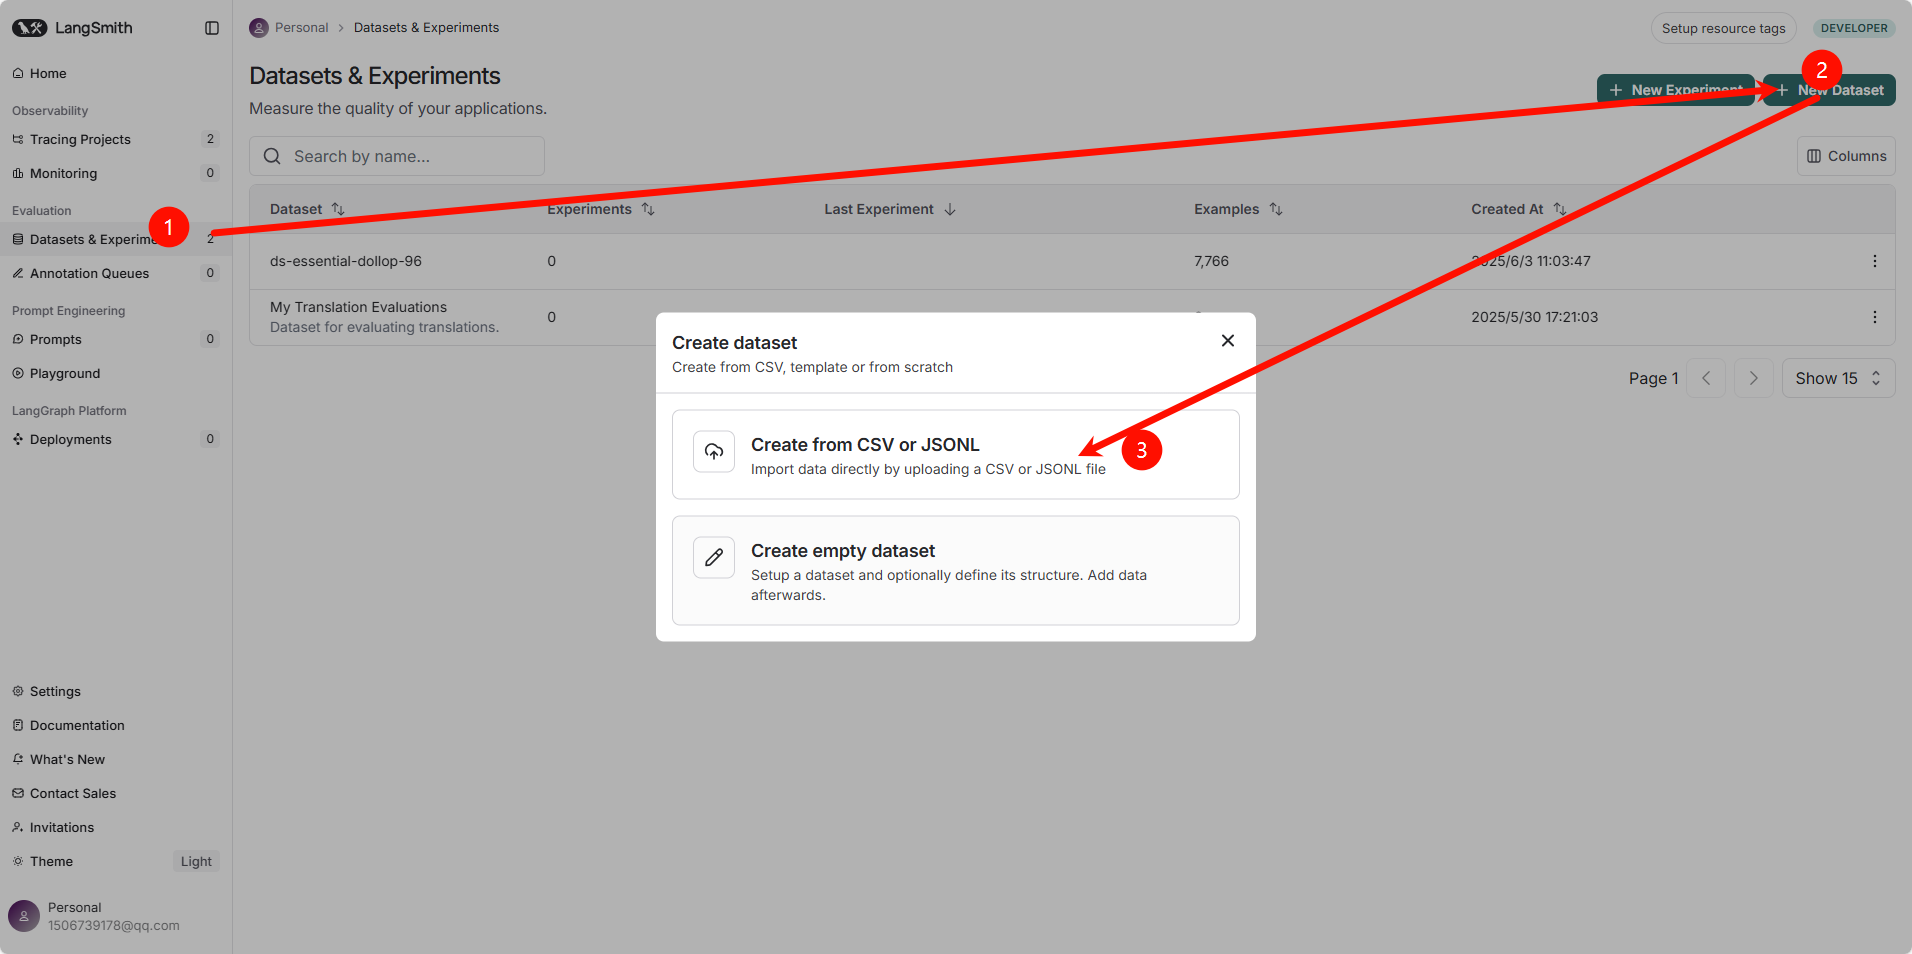
创建数据集
三种方式:
- UI 里手动创建,添加输入和期望输出(Ground Truth)
- 从生产 trace 里筛选样本,「Add to Dataset」存进数据集——基于真实用户交互做评估,这是最推荐的路子
- SDK 代码创建(见下)
SDK 创建数据集并运行评估
from langsmith import Client, evaluate

client = Client()

dataset_name = "My Translation Evaluations"
try:
    dataset = client.create_dataset(dataset_name, description="Dataset for evaluating translations.")
    client.create_example(
        inputs={"input_language": "English", "output_language": "French", "text": "Hello"},
        outputs={"expected_translation": "Bonjour"},
        dataset_id=dataset.id,
    )
except Exception:
    # 大概率是数据集已存在,取现成的
    dataset = client.list_datasets(dataset_name_contains=dataset_name)[0]

# 被评估的目标:包装成「接收 inputs、返回 dict」的函数(chain 即上文的翻译链)
def predict(inputs: dict) -> dict:
    translation = chain.invoke({
        "input_language": inputs["input_language"],
        "output_language": inputs["output_language"],
        "text": inputs["text"],
    })
    return {"output": translation}

# 自定义评估器:精确匹配
def exact_match(run, example) -> dict:
    expected = example.outputs["expected_translation"]
    score = int(run.outputs["output"].strip() == expected)
    return {"key": "exact_match", "score": score}

results = evaluate(
    predict,
    data=dataset_name,
    evaluators=[exact_match],
    experiment_prefix="translation-eval",
)
修订说明:原文这里原本是两行省略号占位(没有可运行代码),上面是按 langsmith SDK 的
evaluate()补全的最小示例,具体参数以官方文档为准。
评估器除了自定义函数,常用的几类:
- 字符串评估器:精确匹配、正则、包含性判断
- LLM-as-Judge:用另一个模型按标准打分(相关性、质量、有害性)
- 轨迹评估器:评 Agent 的完整执行轨迹(工具用得对不对),而不只是最终答案
- 比较评估器:两个版本在同一输入上并排比
⚠️ 版本注记:旧文档里的
RunCollector/QAEvalChain(langchain.evaluation 体系)已被 LangSmith 平台和 SDK 的evaluate()取代,这里留个名字备查。
我的建议
- 先在 LangSmith UI 里熟悉评估流程,再上 SDK
- 应用跑起来、有 trace 上报是评估的前提——评估的对象就是这些运行记录
- 数据集从真实 trace 里攒,比凭空编造更接近真实分布
监控与协作
应用部署后,LangSmith 可以持续监控:仪表盘看延迟、错误率、token 消耗、用户反馈;指标超阈值可设警报;用户点赞/点踩能关联到对应 trace。团队协作方面,组织内共享 trace、数据集和评估结果。
总结
- 接入成本几乎为零:环境变量一设,LangChain 应用自动上报
- 调试靠 trace,迭代靠 Playground + Prompt Hub,质量靠数据集 + 评估
- 观测分工:给用户看的中间过程用 astream_events,记录和分析交给 LangSmith
- 官方文档:docs.smith.langchain.com